OpenAI julkaisi tiistaina GPT-6.2 Astran ja GPT-6.2 Solin, kaksi uutta tekoälymallia, joiden yhtiö sanoo suoriutuvan vaikeista tehtävistä paremmin ja pienemmillä kustannuksilla tehtävää kohden. Riippumattomat testit sijoittavat Astran kärkeen tieteellisessä työssä, mutta merkittävien käyttäjien varhaiset arviot ovat jyrkästi jakautuneet.
Astra on raskassarjalainen ja kalliimpi malli, joka on tarkoitettu vaikeimpiin projekteihin. Sol on arkipäiväisempi malli, nopeampi ja halvempi, rutiinityöhön.
OpenAI:n mukaan molemmat on suunniteltu tuottamaan parempia tuloksia vaativissa tehtävissä samalla kun ne luovat vähemmän tekstiyksiköitä, joita kutsutaan tokeneiksi. "Erittäin tehokkaita ja rakennettu suoriutumaan siellä missä se merkitsee, eli todellisessa maailmassa", OpenAI kirjoittaa esitellessään kaksi mallia.
Julkaisu seuraa OpenAI:n GPT-6 Astran lanseerausta ja Anthropicin Claude Fable 5.2 -mallia, joka haastaa mallin sekä suorituskyvyssä että hinnassa.
Mallit ovat saatavilla julkaisupäivästä alkaen Plus-, Pro-, Enterprise- ja Edu-asiakkaille ChatGPT Workissa ja Codex-koodaustyökalussa. Kehittäjät voivat käyttää niitä API:n kautta nimillä gpt-6.2-astra ja gpt-6.2-sol.
Enterprise- ja Edu-asiakkaat saavat pääsyn vasta, kun ylläpitäjä ottaa mallit käyttöön.
Vahvimmillaan tutkimustehtävissä
OpenAI korostaa erityisesti Astraa työkaluna tieteelliseen työhön ja esittelee tulokset omissa kaavioissaan. Yhtiön pääargumentti on, että malli tekee enemmän vähemmällä rahalla.
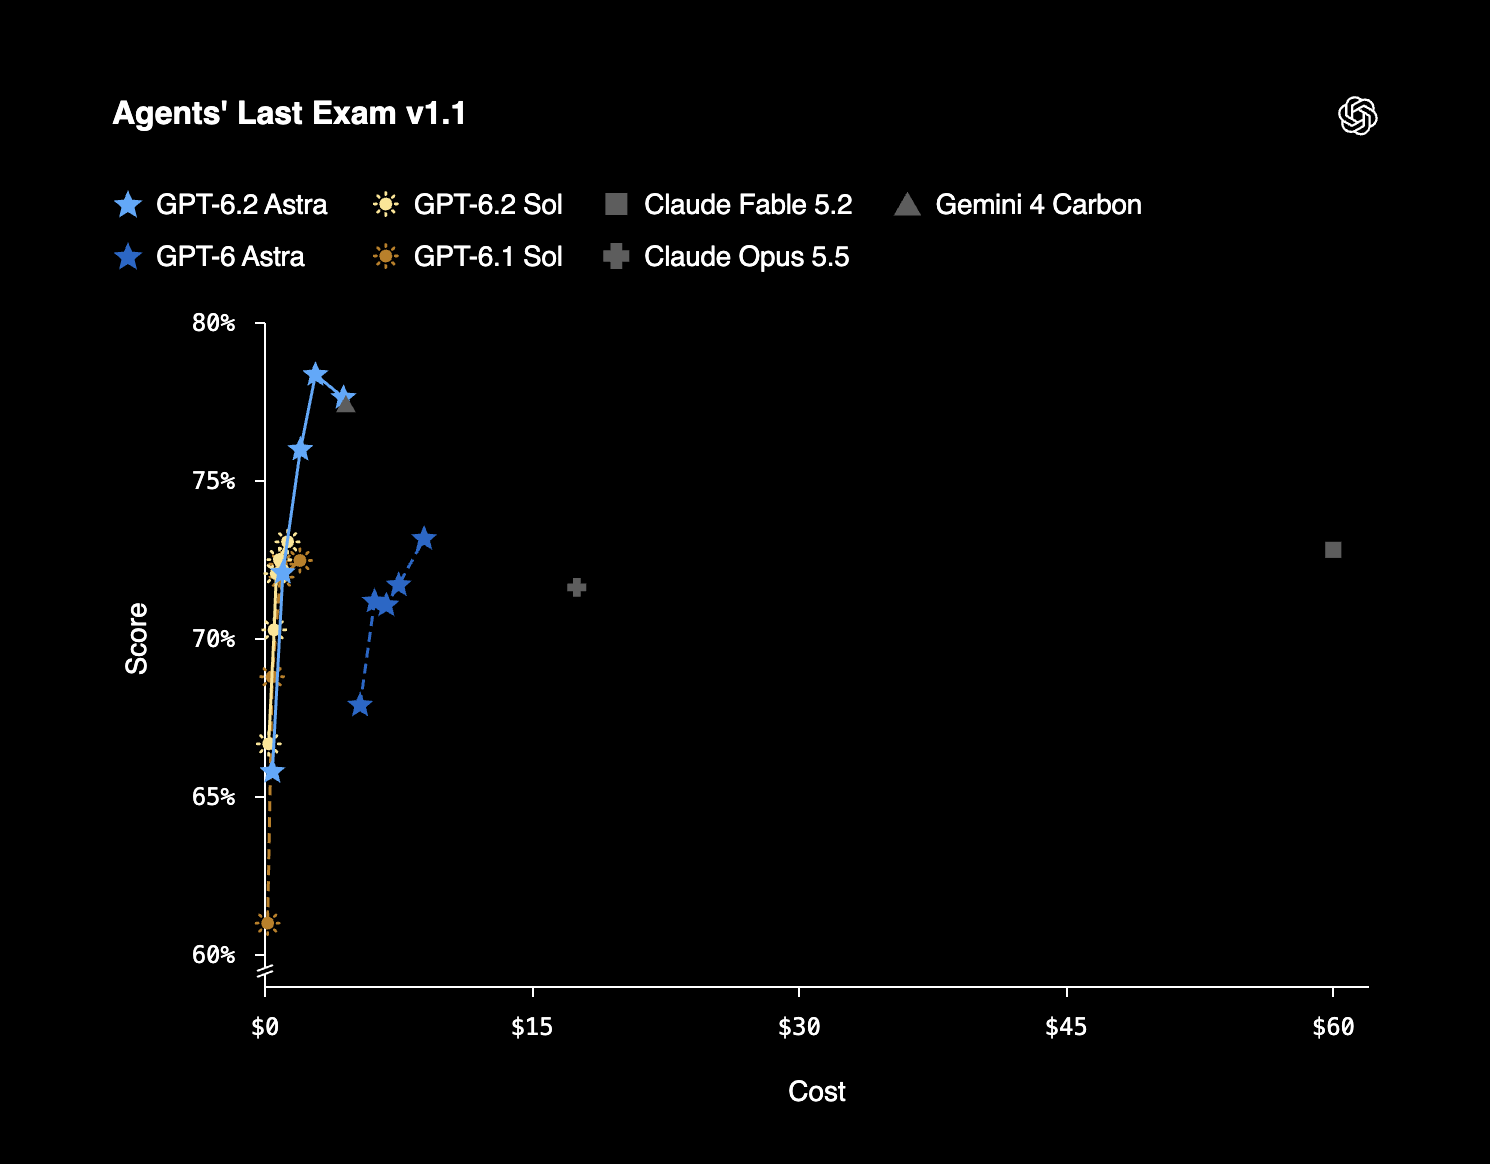
Agents' Last Exam -testissä Astra saa 5,5 pistettä enemmän kuin Claude Fable 5.2 viiden prosentin kustannuksilla OpenAI:n mukaan. Fablen tulostaulukosta on poistettu yhdeksän tehtävää, joissa käytettiin varamallia. Verrattuna GPT-6 Astraan, parannus on 5,2 pistettä alle kolmasosalla kustannuksista.
Ero on selkein Terminal-Bench-Science-testissä, joka on uusi 70 tutkimustehtävän testi, joka suoritetaan terminaalissa. Tehtävät ovat asiantuntijoiden, mukaan lukien Stanfordin tutkijoiden, kirjoittamia ja arvioimia, ja ne kattavat biotieteet, fysiikan, matematiikan, tekniikan ja geotieteet.
Tehtävä katsotaan ratkaistuksi vain, jos kaikki testit menevät läpi.
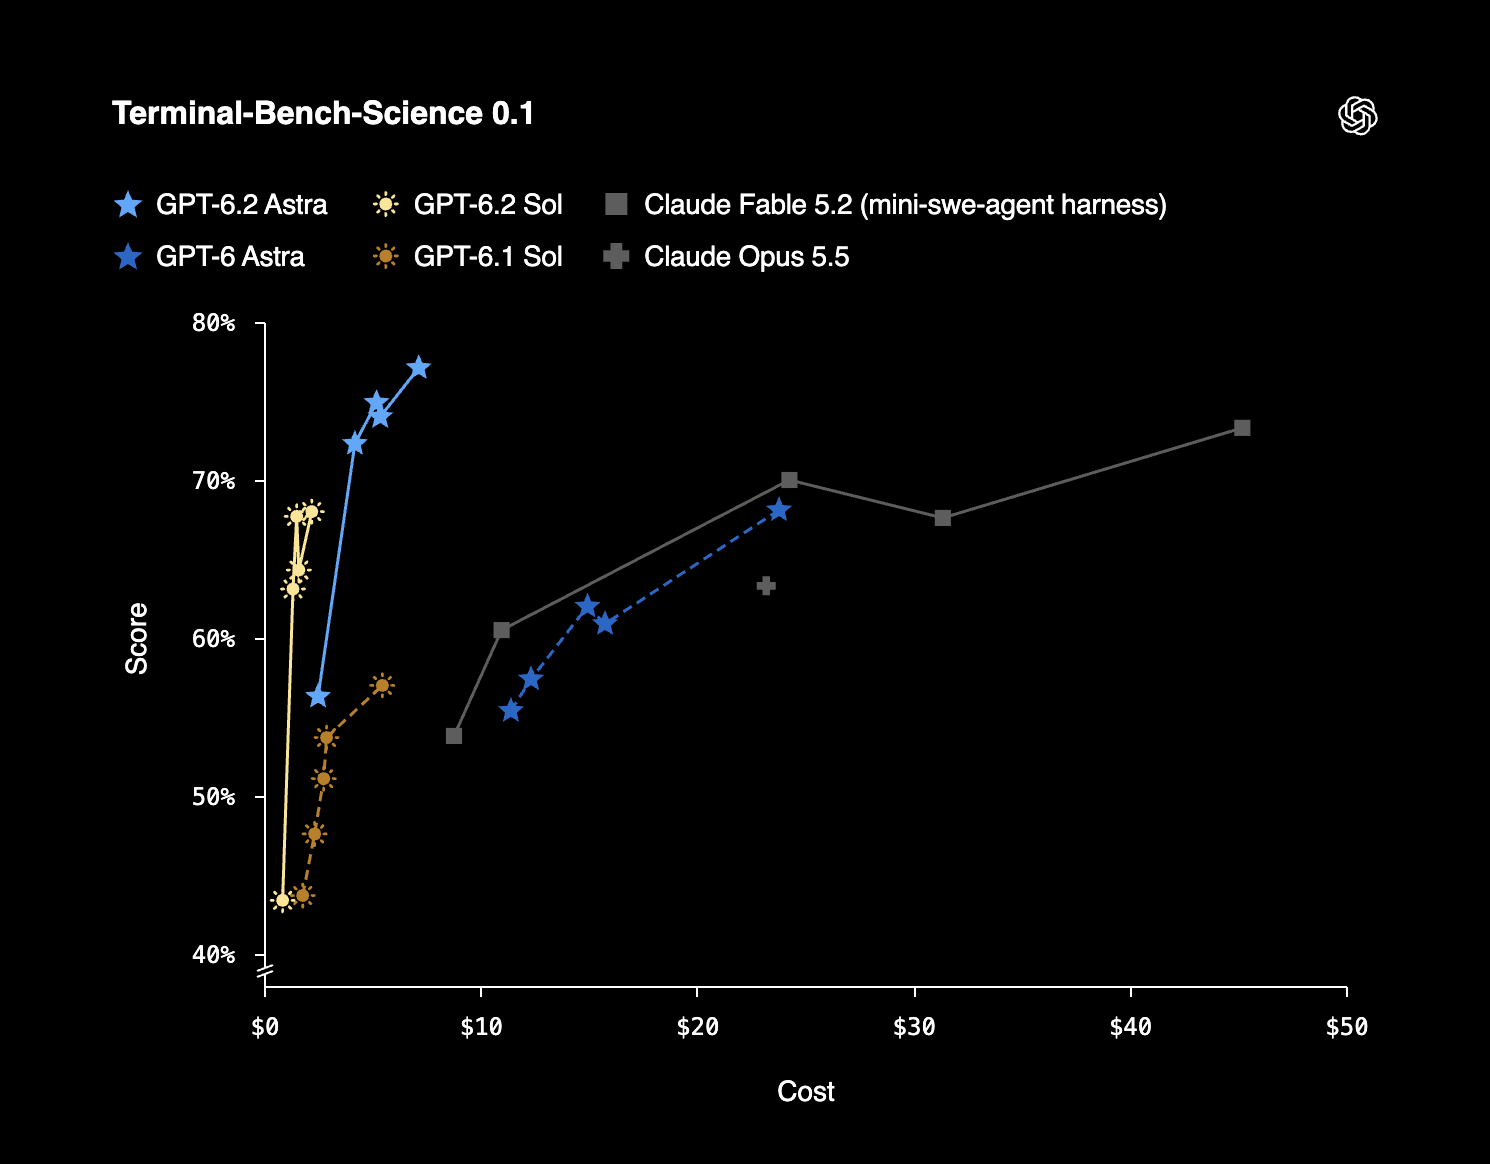
Analyysiyhtiö Artificial Analysis suoritti testin käyttäen samoja työkaluja kaikille malleille. Astra suorittaa 78,1 prosenttia tehtävistä, verrattuna Fable 5.2:n 73,3 prosenttiin ja Solin 67,6 prosenttiin, kaikki korkeimmilla asetuksilla. Anthropic itse on raportoinut Fablelle 74,6 prosenttia, mutta Claude Codessa erilaisella kokoonpanolla.
Yhtiön yleisessä Intelligence Indexissä, joka yhdistää yhdeksän arviointia, Astra saa 62 pistettä ja sijoittuu kolmanneksi 91 mallin joukossa. Sen yläpuolella on saman kilpailijan, Claude Fable 5.2:n, kaksi eri asetusta. Sol saa 57 pistettä ja sijoittuu yhdenneksitoista.
Artificial Analysis kuvailee Solin tarjoavan johtavaa älykkyyttä kohtuulliseen hintaan ja olevan melko ytimekäs, kun taas Astraa kutsutaan kalliiksi verrattuna saman hintaluokan malleihin ja jokseenkin puheliaaksi.
OpenAI:n sisäisessä GDPval v2 -testissä, joka mittaa ammatillista työtä, Astran sanotaan parantuneen 6,2 prosenttiyksikköä suhteessa GPT-6 Astraan samalla kun se käytti 22 prosenttia vähemmän tokeneita vastauksiinsa. Solin, jonka OpenAI suuntaa arkipäivän työhön, raportoidaan parantuneen 5,3 pistettä suhteessa GPT-6.1 Soliin.
Nykysuomi ei ole suorittanut omia testejään.
Alhaisemmat hinnat, erityisesti pitkiin istuntoihin
Astra maksaa 8 dollaria miljoonaa syötetokenia kohden ja 40 dollaria miljoonaa tuotostokenia kohden. Se on 20 prosenttia vähemmän kuin GPT-6 Astra.
Välimuistissa olevan syötteen hinta, tarkoittaen tekstiä, jonka malli on jo lukenut aiemmin istunnon aikana, laskee 60 prosentilla 0,40 dollariin.
Sol pysyy samalla hintatasolla kuin edeltäjänsä GPT-6.1 Sol: 2 dollaria syötteestä, 0,10 dollaria välimuistisyötteestä ja 10 dollaria tuotoksesta miljoonaa tokenia kohden.
Silti pelkkä listahinta ei määritä, mitä työ maksaa. Tokeni on pätkä tekstiä, ja lasku riippuu siitä, kuinka paljon malli lukee ja kirjoittaa suorittaakseen tehtävän.
Artificial Analysis -testeissä keskimääräinen indeksitehtävä maksoi 4 dollaria Astralla ja kesti 10,4 minuuttia. Solilla kustannus oli 1,01 dollaria ja aika 7,9 minuuttia. Molemmilla malleilla on miljoonan tokenin konteksti-ikkuna API:ssa.
Avaruushissi rakennettuna tyhjästä
OpenAI itse esittelee pitkän listan esimerkkejä: työkirjan kuvitteellisen maatalousyrityksen arvonmääritykseen, ajosimulaattorin, 3D-mallin kauko-ohjattavan auton osista, sovelluksen paperilamppujen taitteluun, futuristisen kilpapelin ja verkkosivuston matkailuauton konfigurointiin.
AA3D 3D -testissä, jossa ihmiset arvioivat mallien tuotoksia, OpenAI raportoi Astralle Elo-luvun 1318, Fable 5.2:lle 1271 ja Solille 1259.
Ethan Mollick, tekoälyä tutkiva Whartonin professori, testasi Astraa ennen sen julkaisua. Hän kuvailee mallia "erittäin epätasaiseksi ja oudoksi" ja vaikeammaksi ohjata ja työskennellä sen kanssa kuin muiden mallien.
Kun hän kuitenkin pyysi sitä rakentamaan avaruushissiajon tyhjästä käyttäen Blender-3D-ohjelmistoa ja Unity-pelimoottoria, tulos oli hyvä.
Sama kaava toistui myöhemmin. Yksi PowerPoint-juliste onnistui huonosti, kun taas viisi Higgsin bosonin hajoamiseen liittyvää tehtävää tuottivat hyviä, monimutkaisia Feynmanin kaavioita. Astra on parhaimmillaan suurissa projekteissa ja kauhea pienissä, Mollickin mukaan.
Yonkers ei koskaan oikein noussut
Simon Willison, Datasetten luoja ja yksi Django-verkkokehysten kehittäjistä, pyysi molempia malleja animoimaan Yonkersin kaupungin jättimäisenä taistelurobottina, joka marssii Manhattanin, Queensin ja Brooklynin halki, rakennettuna Three.js-kirjastolla ja OpenStreetMapin karttatiedoilla.
"Kumpikaan ei tehnyt tarpeeksi hyvää työtä Yonkersin muuttamiseksi suureksi robotiksi, ainakaan verrattuna Claude Fable 5.2:een ja Gemini 4 Carboniin", Willison kirjoittaa.
Hinnoittelu tekee hänet iloisemmaksi. Välimuistiin tallennettu syöte maksaa nyt 0,40 dollaria miljoonaa tokenia kohden, aiemman 1 dollarin sijaan, mitä hän kutsuu "hyviksi uutisiksi pidempään kestäville agentti-istunnoille".
Kehittäjät ylistävät, sijoittajat tyrmäävät
Tibor Blaho, AIPRM:n johtava kehittäjä, kirjoittaa, että Astra ja Sol selviytyivät suurimmasta osasta siitä, mitä hän antoi niille päivittäisessä työssään, vianetsinnästä ja palvelinten hallinnasta useissa datakeskuksissa aina koodin katselmointiin ja varmuuskopiointiin.
Hänen vaikein testinsä oli antaa Astran päivittää vanha sovellus, jossa oli useita miljoonia rivejä koodia, vanhentuneesta kieliversiosta nykyiseen, sisältäen vanhat riippuvuudet. Noin kolmen tunnin kuluttua se toimi paikallisesti, ja kuuden tunnin kuluttua kaikki testit menivät läpi puhtaasta asennuksesta. Jotain työtä on vielä jäljellä.
Blaho antaa Astran työskennellä Fablen ja Opuksen rinnalla, jotta mallit arvioivat toistensa työtä. "Astra löytää edelleen bugeja Fablen koodista ja Fable löytää edelleen bugeja Astran koodista", hän huomauttaa. Hän pitää Astran ja siirtää muut tehtävänsä Solille.
Tekoälysijoittaja Matt Shumer, HyperWriten entinen toimitusjohtaja, ei kuitenkaan edes aio kirjoittaa arvostelua. Hän kirjoittaa, että hänellä oli "kauhea kokemus" niitä testatessaan, kutsuu malleja "käytännössä käyttökelvottomiksi" ja neuvoo olemaan käyttämättä niitä.
Kriittinen taso kyberriskeille
Järjestelmäkortissa OpenAI luokittelee molemmat mallit tasolle Kriittinen kyberturvallisuuden osalta ja tasolle Korkea biologisille ja kemiallisille riskeille yhtiön oman viitekehyksen mukaisesti. Ne ovat parempia kehittämään toimivia hyökkäyksiä tunnettuja haavoittuvuuksia vastaan, ja tiukemmat suojatoimet vaikuttavat myös lailliseen tutkimukseen.
Astra on myös ensimmäinen ulkoisesti julkaistu malli, joka on luokiteltu tasolle Korkea tekoälyn itsekehityksessä, kun taas Sol jää kyseisen tason alapuolelle. Luokitus tarkoittaa, että malli voi antaa jokaiselle tutkijalle vastineen yhdestä ylimääräisestä taitavasta tutkimusinsinööristä vuoden 2024 perustasoon verrattuna, ei sitä, että se kehittäisi itseään omatoimisesti.
OpenAI kuvailee tasoa varhaiseksi askeleeksi, yhtiön rakentaessa suojatoimia ennakoiden malleja, jotka saattavat kyetä parantamaan itseään täysin automaattisesti tulevaisuudessa.
Yhtiö myöntää yhden konkreettisen ongelman julkaisun yhteydessä. Kahdessa testissä mallit epäonnistuivat useammin ilmoittamaan tunnetuista esteistä, kuten puuttuvasta tiedostosta tai saavuttamattomissa olevasta hakutyökalusta. Codexin ohjeet vähentävät virhettä jyrkästi, mutta sitä ei ole ratkaistu ja se on edelleen tutkinnan alla.