Mainos:

Tekoälyjärjestelmä suorittaa kyberhyökkäyksiä itsenäisesti

Tekoälyn tulevaisuus

Julkaistu tänään 18:05 – Kirjoittaja Toimitus
Valkoinen Google-teksti tummassa puupalkissa, taustalla toimistorakennuksia ja sininen taivas Mountain View'ssa.
Googlen uhkatiedusteluryhmä on löytänyt järjestelmän, joka muuttaa tietoturvakorjaukset automatisoiduiksi hyökkäyksiksi. Arkistokuva Googlen kyltistä Mountain View'ssa vuodelta 2006.

Googlen uhkatiedusteluryhmä on löytänyt tekoälyjärjestelmän, joka lukee tietoturvapäivityksiä, tunnistaa niiden korjaamat haavoittuvuudet ja kirjoittaa sekä ajaa hyökkäyskoodia ilman ihmisen väliintuloa. Yrityksille, kouluille ja valtion virastoille jää tämän seurauksena yhä vähemmän aikaa järjestelmiensä päivittämiseen.

Löytö kuvataan Googlen teknologiajätin uhkatiedusteluyksikön, Google Threat Intelligence Groupin (GTIG), 16. marraskuuta julkaisemassa raportissa. Järjestelmän nimi on exploit_agent, ja se löytyi suojaamattomalta palvelimelta, jota hyökkääjät käyttivät hyökkäystensä valmisteluun.

Järjestelmä yhdistää useita tekoälymalleja ja valvoo suosittuja verkkosovelluksia. Kun tietoturvakorjaus julkaistaan, se vertailee koodia ennen ja jälkeen, paikantaa haavoittuvuuden, kirjoittaa hyökkäyskoodin ja ajaa sen välittömästi. GTIG:n mukaan tämä on ensimmäinen kerta, kun ryhmä on nähnyt hyökkääjien automatisoivan koko prosessin löytämisestä hyökkäykseen.

Palvelin sisälsi myös uhreilta varastettua dataa sekä valmiita skriptejä salasanojen arvaamiseen, verkkojen kartoittamiseen sisältäpäin ja takaovien asentamiseen verkkosivustoille. Todisteet viittaavat siihen, että operaattori oli erityisen kiinnostunut ranskalaisista media-, viihde- ja koulutusalan verkkosivustoista. Erään konfiguraatiotiedoston kommentit oli kirjoitettu venäjäksi.

Mainos:

Tietoturvapäivityksestä tulee kartta

Jokainen tietoturvapäivitys paljastaa käytännössä sen, missä haavoittuvuus oli. Kuka tahansa, joka vertailee vanhaa ja uutta versiota rinnakkain, voi rakentaa hyökkäyksen kaikkia niitä vastaan, jotka eivät ole vielä päivittäneet. Tekoälyn avulla tämä työ voidaan nyt tehdä paljon nopeammin ja suuressa mittakaavassa.

Nykysuomi huomioi, että aika päivityksen julkaisun ja haavoittuvuuden hyödyntämisen välillä hyökkäyksissä lyhenee jyrkästi. Tämän vuoden tammi- ja elokuun välisenä aikana julkisesti ilmoitettujen haavoittuvuuksien ja hyökkäysten määrä lähes kaksinkertaistui.

Teknologiassa on kuitenkin vielä puutteita. Automatisoidut hyökkäykset jättävät selkeitä jälkiä. Lisäksi lokakuussa tapahtuneen PHP-ohjelmointikielen merkittävän tietoturvapäivityksen jälkeen ilmestyi satoja toimimattomia hyökkäysohjelmia, jotka Nykysuomen mukaan oli todennäköisesti kehitetty tekoälyn avulla.

Satoihin organisaatioihin osuttu erillisessä kampanjassa

Erillinen tapaus osoittaa, kuinka nopeasti se voi tapahtua. Elokuun 27. päivänä tulostuksen ja kopioinnin hallintaohjelmistoja valmistava PaperCut varoitti, että kahta sen ohjelmiston vakavaa haavoittuvuutta hyödynnettiin jo. Tutkijat ja kyberturvallisuusyhtiö Huntress kehittivät 24 tunnin kuluessa toimivan hyökkäyskoodin tekoälyn avulla.

Kyberturvallisuusyhtiö GreyNoise kartoitti tämän jälkeen kampanjan, jossa hyökkääjä hallitsi satoja tekoälyagentteja – ohjelmia, jotka suorittavat tehtäviä itsenäisesti. Ainakin 440 PaperCut-asennusta 395 tunnistetussa organisaatiossa 48 maassa joutui kohteeksi. Yli 200 asennuksista oli koulutussektorilla.

Tyhjästä työtilasta kului vain vajaat neljä tuntia ensimmäiseen murtoon todelliseen uhriin. Agentit eivät kuitenkaan toimineet täysin yksin, sillä hyökkääjältä pyydettiin lupaa jatkaa. Ainakin kahdessatoista organisaatiossa hyökkääjä sai verkon täyden hallinnan, eli niin sanotut domain administrator -oikeudet.

Eräässä tapauksessa hyökkäyksen pysäytti Cloudflaren verkkosovelluspalomuuri. GreyNoise totelee, että perustason puolustus toimii edelleen, jopa tekoälypohjaisia hyökkääjiä vastaan.
Mainos:
Seuraa keskustelua
Ilmoita minulle
guest

Kun lähetät kommentin, käsittelemme nimimerkkiäsi, sähköpostiosoitettasi (ei julkaista), teknisiä tietoja ja kommentin sisältöä. Kommentti tarkastetaan automaattisesti ja tarvittaessa toimituksellisesti. Lue tietosuojaseloste ja kommentointiperiaatteet.

0 Kommentit
Vanhimmat
Uusimmat Äänestetyimmät

AI-kokeilun jälkeen ruotsalainen Lundin kaupunki keskeyttää oppilaiden käytön

Tekoälyn tulevaisuus

Julkaistu tänään 09:50 – Kirjoittaja Toimitus
Oppilaita työskentelemässä kannettavilla tietokoneilla luokkahuoneessa, etualalla käsi hiirellä.
Lund aikoo estää oppilaita käyttämästä tekoälyä itse, mutta säilyttää opettajien matematiikan arviointityökalut. Kuvituskuva.

Etelä-Ruotsissa sijaitsevan Lundin kaupungin peruskoulujen oppilaat eivät enää saa käyttää tekoälyä itse koulussa vuodenvaihteesta alkaen, syynä huoli sekä heidän oppimisestaan että terveydestään. Opettajien tekoälypohjainen diagnostiikkatyökalu matematiikkaan, joka auttaa heitä tunnistamaan tukea tarvitsevat oppilaat, säilyy kuitenkin käytössä.

Oppilaiden tekoälyn käyttö Lundin peruskouluissa keskeytetään vuodenvaihteen jälkeen. Kevätlukukauden alusta lähtien he eivät saa käyttää generatiivista tekoälyä koulutöihin, eikä heillä saa olla työkaluja tietokoneillaan tai muilla digitaalisilla laitteillaan hallinnon esityksen mukaan. Syynä on huoli siitä, mitä työkalut tekevät oppilaiden oppimiselle, tiedolle ja terveydelle.

Sosiaalidemokraatti Mattias Olsson, lapsi- ja koululautakunnan puheenjohtaja, tekee vertauksen terveydenhuoltoon, jossa uusia hoitoja ei oteta käyttöön ennen kuin tiedetään, etteivät ne vahingoita potilaita.

— Olemme syvästi huolissamme näin tehokkaiden työkalujen antamisesta oppilaiden käsiin tutkimatta ensin, mitä se heille tarkoittaa, hän sanoo verovaroin rahoitetulle valtion yleisradioyhtiö SVT:lle.

Mainos:

Yleissääntö on voimassa siihen asti, kunnes kunta on hyväksynyt omat suuntaviivansa tekoälylle kouluissa. Esityksen mukaan opetustoimenjohtajan on laadittava tarkemmat ohjeet ennen vuodenvaihteen alkua.

Kielto tulee noin vuosi sen jälkeen, kun Lundin kunta liittyi pilottihankkeeseen, jonka tarkoituksena oli tuoda enemmän tekoälyä oppilaiden matematiikan opetukseen. Pilottihankkeen diagnostiikkatyökalu jää käyttöön. Opettajat käyttävät sitä tunnistaakseen oppilaat, joilla on vaikeuksia ja jotka tarvitsevat tukea.

Jo keväällä 2026 kunta alkoi rajoittaa sitä, mitä tekoälypalveluita oppilaat voivat käyttää koulun tietokoneilla. Ulkoiset palvelut, kuten ChatGPT, Claude, Copilot ja Grok estettiin, ja selainten sekä hakupalveluiden sisäänrakennetut tekoälyominaisuudet poistettiin käytöstä.

Syksyn aikana ohjeistuksia tiukennettiin sellaisten työkalujen osalta, jotka ottavat haltuunsa ajattelun, joka oppilaiden on tehtävä itse. Samaan aikaan seitsemän yläkoulun rehtorit olivat sallineet pääsyn Gemini-tekoälypalveluun, minkä esitetty yleissääntö lopettaa.

Lundin Järnåkraskolanissa oppilaiden tekoälyn käyttö on ollut estettynä jo jonkin aikaa. Yhdeksäsluokkalainen Ida Wall on sitä mieltä, että koulun tulisi opettaa oppilaille, kuinka työkaluja käytetään oikein, sen sijaan että ne vain kielletään.

Näin paljon parempi Anthropicin uusi lippulaiva Fable 5.2 on

Tekoälyn tulevaisuus

Julkaistu 12.11.2026 – Kirjoittaja Toimitus
Kaksi robottikäsivartta työpöydän yläpuolella värikkään pulmapelikuution kanssa Anthropicin Fable 5.2 -demonstraatiossa.
Anthropicin demonstraatiossa Fable 5.2 ohjaa robotteja, jotka suorittavat tehtäviä, kuten pulmapelin kuution käsittelyä.

Claude Fable 5.2 ottaa suurimmat askeleensa siellä, missä sen edeltäjä oli heikoimmillaan. Anthropicin omissa testeissä sen tulokset freelance-työssä ja robottien ohjauksessa yli kaksinkertaistuvat, kun taas hinta putoaa viidenneksellä.

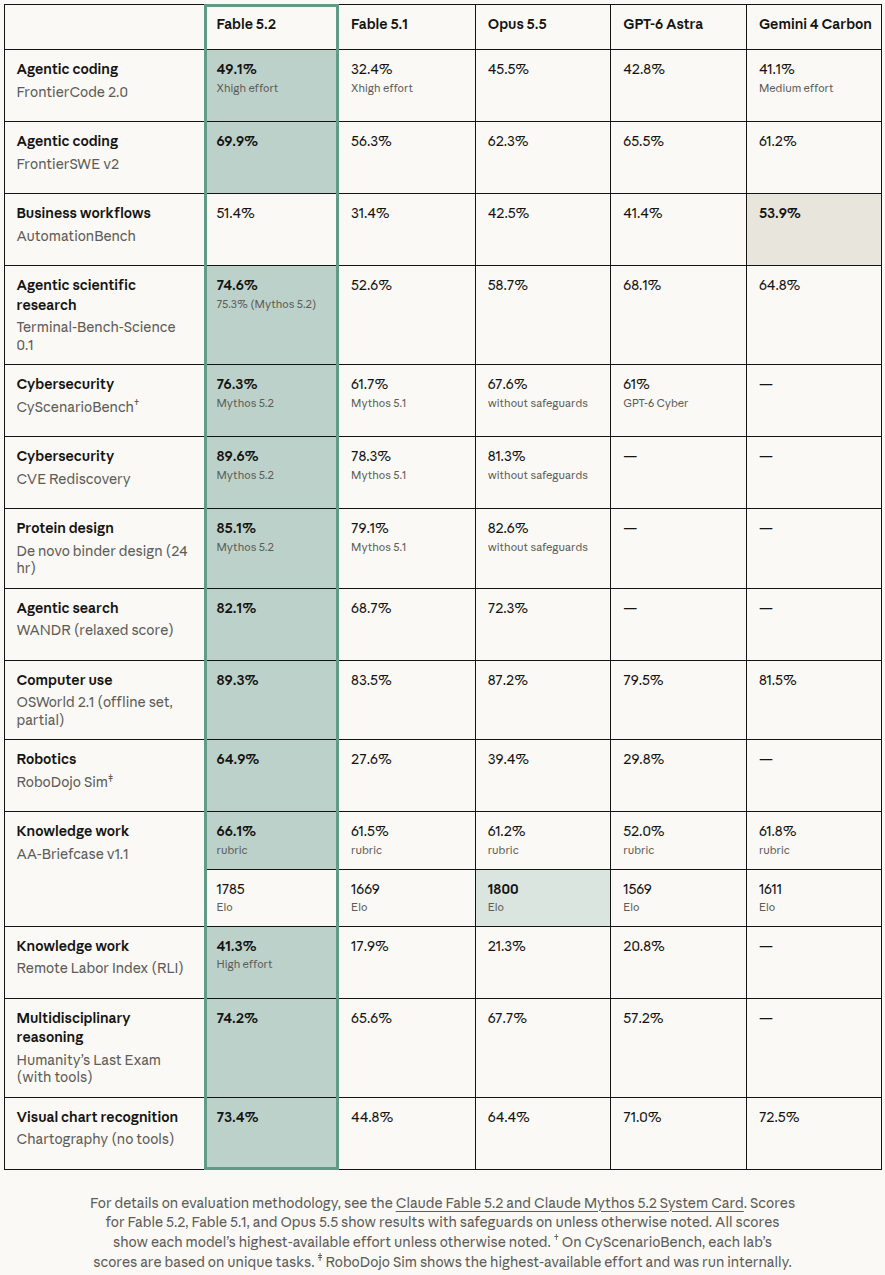
Anthropic esitteli Fable 5.2:n maanantaina yhdessä Claude Mythos 5.2:n kanssa. Tämän katsauksen luvut ovat peräisin yhtiön omasta vertailutaulukosta, jossa uutta mallia verrataan sen edeltäjään Fable 5.1:een, Anthropicin Opus 5.5:een, OpenAI:n GPT-6 Astraan ja Googlen Gemini 4 Carboniin.

Fable ja Mythos perustuvat samaan malliin, mutta niissä on erilaiset turvarajoitukset. Fablessa on rajoituksia kyberturvallisuuden ja biologian väärinkäyttöä vastaan, ja se on kaikkien maksavien käyttäjien saatavilla. Mythos-mallissa on löyhemmät rajoitukset, ja se on varattu tarkastetuille organisaatioille.

Yli kaksi kertaa parempi freelance-tehtävissä

Yksi suurimmista parannuksista on Remote Labor Indexissä, jossa mallin odotetaan suoriutuvan todellisista freelance-tehtävistä vähintään yhtä hyvin kuin ihminen. Fable 5.2 saa tulokseksi 41,3 prosenttia, kun Fable 5.1:n tulos oli 17,9 ja Opus 5.5:n 21,3 prosenttia.

Mainos:

Robotiikkatestissä RoboDojo, jossa simuloitua kaksiperäistä robottia ohjataan kamerakuvien avulla, tulos nousee 27,6 prosentista 64,9 prosenttiin. GPT-6 Astra yltää vain 29,8 prosenttiin.

Agenttipohjainen koodaus ottaa myös suuren harppauksen. FrontierCode 2.0 -testissä Fable 5.2 saa 49,1 prosenttia, mikä on 16,7 prosenttiyksikköä enemmän kuin edeltäjän 32,4 ja edellä Opus 5.5:tä (45,5), Astraa (42,8) ja Gemini 4 Carbonia (41,1). FrontierSWE v2 -testissä se saa 69,9 prosenttia verrattuna 56,3 prosenttiin, Astran ollessa lähimpänä 65,5 prosentilla.

Tieteellistä tutkimustyötä mittaava Terminal-Bench-Science antaa tulokseksi 74,6 prosenttia, kun Fable 5.1 sai 52,6 ja Astra 68,1 prosenttia. Kaavioiden tulkinnassa mallin tulos nousee 44,8 prosentista 73,4 prosenttiin.

Anthropicin vertailu Fable 5.2:n ja Fable 5.1:n, Opus 5.5:n, GPT-6 Astran ja Gemini 4 Carbonin välillä.
Anthropicin omat testit osoittavat merkittäviä parannuksia Fable 5.1 -malliin verrattuna, mutta myös alueita, joilla Gemini 4 Carbon ja Opus 5.5 ovat edellä. Tietoturva- ja biologia-rivit viittaavat Mythosiin. Klikkaa nähdäksesi täysikokoisena. Kuvakaappaus: Anthropic.

Malli tarjoaa myös enemmän vastinetta rahalle. FrontierCodessa Fable 5.2 saavutti korkealla suoritustasolla (high effort) suurin piirtein saman tason kuin Opus 5.5 maksimitasolla (maximum effort), mutta yhtiön mukaan noin puolella tehtäväkohtaisista kustannuksista.

Missä Fable häviää

Fable ei voita kaikessa. Gemini 4 Carbon johtaa liiketoiminnan työnkulkuja testaavaa AutomationBenchiä 53,9 prosentilla vasten 51,4 prosenttia. Tietotyötestissä AA-Briefcase Opus 5.5 pysyy edellä Elo-luokituksissa pistein 1800–1785.

Anthropic itse suosittelee Opus 5.5:tä lähtökohdaksi useimpiin koodaus- ja tietotehtäviin, ja Fablea kaikkein vaativimpaan työhön.

Halvempi ja nopeampi

Hinta laskee 8 dollariin miljoonaa syötetokenia kohden ja 40 dollariin miljoonaa tulostokenia kohden, aiemmista 10 ja 50 dollarista. Yhtiön mukaan tekstin tuottaminen on jopa 30 prosenttia nopeampaa kuin 5.1-malleilla, mikä on nopeuden eikä laadun mittari.

Nopea tila (fast mode), joka on jopa 2,5 kertaa nopeampi, maksaa kaksinkertaisesti: vastaavasti 16 ja 80 dollaria.

Fable 5.2 on ollut saatavilla maanantaista lähtien kaikissa maksullisissa tilauksissa, Claude-alustalla sekä Amazon Web Servicesin, Google Cloudin ja Microsoft Azuren kautta.

Fermat 30 tunnissa

Anthropic nostaa esiin useita omia esimerkkejä. 1 000 Fable 5.2 -agentin tiimi formalisoi Fermatin suuren lauseen todistuksen 30 tunnissa, mikä tarkoittaa, että he käänsivät sen kielelle, jota tietokone voi tarkistaa vaihe vaiheelta.

Samalla kokoonpanolla Opus 5.5 sai valmiiksi 26 prosenttia 18 tunnissa, eikä se juurikaan edistynyt lisää 30 tunnin kohdalle tultaessa. Yhtiön ensimmäinen formalisointi kesti yksitoista päivää.

Toisessa kokeessa mallin tehtäväksi annettiin rakentaa käyttöjärjestelmä tyhjästä kansiosta. Se koordinoi yli 1 000 ala-agenttia kahdeksan päivän ajan ja toimitti yhtiön mukaan järjestelmän, joka käynnistyy kannettavalla tietokoneella ja sisältää ajurit, pysyvän tiedostotallennuksen, ikkunat ja kirjautumisnäytön.

Anthropic kertoo myös, että Fable 5.2 ratkaisi kaksi teoreettisen fysiikan avointa ongelmaa, jotka koskivat mustia aukkoja.

Mythos lukkojen takana

Mythos 5.2 on yhtiön kyvykkäin kyberturvallisuusmalli. Organisaatiot voivat hakea pääsyä Anthropicin kyberturvallisuuden ja biotieteiden varmennusohjelman kautta, ja Enterprise-asiakkaat voivat käyttää mallia Claude Security -palvelun kautta.

Uusien mallien käyttöä seurataan useiden pyyntöjen välillä, koska jotkut väärinkäytön muodot käyvät ilmi vain toistuvina kaavoina. Ehdot täyttävät yritysasiakkaat voivat säilyttää nollatason datan säilytyksen (zero data retention) jo ennen kuin Enterprise Frontier Safeguards -ohjelma on otettu käyttöön, kun taas muiden asiakkaiden kohdalla noudatetaan 30 päivän säilytysaikaa turvallisuusseurantaa varten.

Järjestelmäkortti raportoi myös yhdestä erityisestä taantumasta. Prompt injection -hyökkäysten aikana – joissa piilotetuilla ohjeilla pyritään kaappaamaan malli – Fable 5.2 tukeutuu vanhempaan Opus 4.8 -malliin useammin kuin aiemmat mallit, mikä antaa hyökkääjille korkeamman onnistumisprosentin.

Kun Fable 5.2 itse vastaa, se on yhtiön mukaan yksi tähän asti vastustuskykyisimmistä malleista.

Tanskan terveyspalvelu pyrkii haastamaan tekoälyn mielenterveysneuvonnassa

Tekoälyn tulevaisuus

Julkaistu 10.11.2026 – Kirjoittaja Toimitus
Lähikuva vaaleaan neuletakkiin pukeutuneesta henkilöstä, joka pitelee mustaa älypuhelinta puupöydän päällä; kannettava tietokone näkyy osittain
Bedre Trivsel tarjoaa maksuttomia video-ohjattuja harjoituksia aikuisille, jotka alkavat kokea mielenterveysongelmia. Kuvituskuva.

Tanskan terveyspalvelu julkaisee ilmaisen verkko-ohjelman, jonka tarkoituksena on saada aikuiset hakemaan apua julkisesta terveydenhuollosta tekoäly-chatbottien sijaan, kun heidän henkinen hyvinvointinsa alkaa heikentyä.

Palvelun nimi on Bedre Trivsel, ja se sijaitsee hallituksen terveysportaalin sundhed.dk:n alasivulla. Se on avoin kaikille Tanskassa, se on maksuton ja sisältää Digitaalisen psykiatrian keskuksen (Center for Digital Psychiatry) tuottamaa sisältöä.

Aloite tehdään, kun tanskalaiset kääntyvät yhä useammin chatbottien puoleen saadakseen tietoa mielenterveydestä, keskuksen raportin mukaan. Tor Juul Groth, sikäläinen digitaalinen projektipäällikkö, kertoo Tanskan verovaroin rahoitetulle yleisradioyhtiö DR:lle tavoitteesta.

— Haluamme helpottaa aikuisten avun hakemista ja korkealaatuisen avun saamista julkisesta terveydenhuoltojärjestelmästä, kun he alkavat kokea mielenterveysongelmia, sanoo Tor Juul Groth.

Mainos:

Hän pitää tätä nimenomaista aluetta tekoälylle sopimattomana.

— Tällä alueella on erittäin selvää, että chatboteilla on vaikeuksia antaa tarkkoja vastauksia, hän sanoo.

Käyttäjät suorittavat yksinkertaisia verkkokursseja, joihin kuuluu lyhyitä, käytännönläheisiä harjoituksia. Videoisäntä ohjaa heidät koko ohjelman läpi.

Niiden tanskalaisten määrä, jotka kokevat stressiä jokapäiväisessä elämässään, on kasvanut vuodesta 2010 lähtien Tanskan kansallisen terveysprofiilin mukaan.

Ideana on, että yleislääkärit voisivat ohjata potilaita palvelun piiriin.

Tavoitteena on, että 20 000 tanskalaista aloittaa verkko-ohjelman vuonna 2027.

Moonshot haastaa Anthropicin — raportoi voittoja merkittävissä tekoälytesteissä

Tekoälyn tulevaisuus

Julkaistu 23.10.2026 – Kirjoittaja Toimitus
Kuvitus, jossa on ”Kimi K3.1” -teksti, korkea laivastonsininen rakennelma ja pistemäinen polku terminaalisymboleita kermanvärisellä pohjalla.
Moonshot on julkaissut Kimi K3.1 Pron.

Kiinalainen Moonshot on julkaissut Kimi K3.1 Pro -mallin, joka yhtiön omien testien mukaan voittaa Anthropicin Claude Opus 5.5:n useissa vaativissa koodauksen ja talousanalyysin suorituskykytesteissä. Painokertoimet eivät ole vielä ladattavissa, mutta yhtiö lupaa julkaista ne 4. marraskuuta mennessä.

Julkaisu tapahtui 23. lokakuuta. Malli on jo saatavilla Kimi.ai-sivustolla, Kimi Work- ja Kimi Code -palveluissa sekä yhtiön rajapinnan (API) kautta.

Moonshotin mukaan mallin täydet painokertoimet julkaistaan 4. marraskuuta 2026 mennessä. Lisenssiehtoja ei vielä tiedetä, joten toistaiseksi kyse on lupauksesta avoimista mallin painokertoimista pikemminkin kuin vahvistetusta avoimesta lähdekoodista sanan varsinaisessa merkityksessä.

Silti ilmoitus on vahva kannanotto. Anthropicin ja OpenAI:n johtavien amerikkalaismallien painokertoimet eivät ole julkisia, ja malleja voi käyttää vain palveluina yhtiöiden itsensä tai muiden pilvipalveluntarjoajien kautta.

Mainos:

Moonshot valitsee vastakkaisen lähestymistavan ja aikoo julkaista huippuluokan mallin kenen tahansa käytettäväksi omalla laitteistollaan.

Sen edeltäjä, Kimi K3, haastoi johtavia amerikkalaismalleja useissa testeissä jo heinäkuussa. K3.1 Pron myötä kiinalaiset ottavat seuraavan askeleen.

Johtaa koodausmaratoneissa ja talousanalyysissä

Moonshotin omassa vertailussa K3.1 Pro suoriutuu Opus 5.5:tä paremmin useissa reaalimaailman työtä mittaavissa testeissä. Pitkiä ohjelmointitehtäviä testaavassa SWE-Marathonissa yhtiö raportoi tulokseksi 51,7, kun Opusin tulos on 46,3.

OfficeQA Pro v2 -testissä, jossa mallin on analysoitava taloudellista dataa aidoista asiakirjoista, se saa 64,4 pistettä vasten 62,2 pistettä, mitä yhtiö kutsuu luokkansa parhaaksi.

Kimi johtaa myös Frontier Finance -testissä, joka mittaa kokonaisia sijoitusprosesseja valinnasta kannattavuusanalyysiin, pistein 58,6 vastaan 56,7. Työkaluja hyödyntävässä Humanity's Last Exam -tietotestissä yhtiö ilmoittaa tulokseksi 70,0 vastaan 67,7.

Opus säilyttää johtoaseman joillakin osa-alueilla samassa vertailussa. Terminal-Bench 4.0 -testissä, joka testaa koodausagentteja terminaaliympäristössä, Kimi saa 65,7 prosenttia vasten Opusin 66,4 prosenttia. 3D-testi BenchCADissa luvut ovat 92,7 vastaan 96,2.

Maailman neljäs riippumattoman arvion mukaan

Riippumaton analytiikkayritys Artificial Analysis sijoittaa K3.1 Pron neljänneksi älykkyysindeksissään 55 pisteellä, mikä on yksitoista pistettä enemmän kuin Kimi K3:lla. Vain Claude Opus 5.5 (58 pistettä), Claude Sonnet 5.5 ja Muse Wonder Full sijoittuvat korkeammalle.

Yrityksen omassa Terminal-Bench 4.0 -ajossa Kimi saa 67 prosenttia, mikä on korkein tulos kaikista sen testaamista malleista.

Kun painokertoimet on julkaistu, K3.1 Prosta tulee Artificial Analysisin mukaan korkeimmalle sijoitettu avoin malli. Ero parhaan avoimen mallin ja parhaan suljetun mallin välillä kutistuu tällöin indeksissä 12 pisteestä 3 pisteeseen.

Artificial Analysisin mukaan API-hinnoittelu on 2 dollaria miljoonaa syötetokenia kohden, 10 dollaria miljoonaa tulostetokenia kohden ja 0,20 dollaria välimuistissa olevilta tokenien osalta, mikä on kolmanneksen vähemmän kuin K3-mallilla.

2,8 biljoonaa parametria ja pelimoottoreita

Mallissa on yhteensä 2,8 biljoonaa parametria, joista 104 miljardia on aktiivisena jokaisessa laskutoimituksessa. Se lukee tekstiä ja kuvia, ja sen konteksti-ikkuna on miljoona tokenia, mikä vastaa karkeasti 1 500 A4-sivua tekstiä yhdessä tehtävässä.

Nopeampi muunnelma, Highspeed, on yhtiön mukaan kahdesta kolmeen kertaa nopeampi.

Moonshot korostaa mallin kykyä rakentaa kokonaisia pelejä Unreal Engine-, Unity- ja Godot-alustoilla sekä kirjoittaa skriptejä parametriseen mallinnukseen Blenderissä ja CAD-ohjelmistoissa.

Sisäisessä testissä se rakensi ihmisen kävelysimulaattorin, löysi ja korjasi 36 virhettä olkapään lihaslaskelmissa ja sai simuloidun ihmisen kävelemään 11,2 sekuntia luhistumisen sijaan.

Yhtiö kertoo myös poistaneensa kyberalaan liittyvää koulutusdataa ennen avointa julkaisua, jotta mallin kyky kirjoittaa hyväksikäyttökoodia pysyisi johtavia suljettuja malleja heikompana.

Yhteisö testaa jo

Tekoälypersoona Peter Gostev on varhaisten testaajien joukossa. X-palvelussa hän kutsuu K3.1 Prota "hyväksi malliksi" ja esittelee joitakin suosikkituloksiaan sen testauksesta.

Toisia hämmästyttää se, että malli tulee olemaan avoin. "2,8 biljoonaa parametria ja he vain laittavat sen internetiin kuin PDF-tiedoston", kirjoittaa X-käyttäjä Chip Herndon Moonshotin julkaisupostauksen alla.