Mainos:

SpaceXAI julkaisi Grok 4.7:n – parempaa koodia muuttumattomalla hinnalla

Tekoälyn tulevaisuus

Julkaistu 21.9.2026 – Kirjoittaja Toimitus
Grok 4.7 julkaistiin maanantaina samalla API-hinnalla kuin Grok 4.6 – 2 dollaria sisään ja 6 dollaria ulos miljoonaa tokenia kohti.

Tekoälyyhtiö SpaceXAI (entinen xAI) julkaisi maanantaina Grok 4.7 -mallin kutsuen sitä kyvykkäimmäksi mallikseen koodaukseen ja tietotyöhön. Se maksaa saman verran ja vastaa yhtä nopeasti kuin edeltäjänsä Grok 4.6, ja se on välittömästi saatavilla Cursorissa, Grok Buildissa sekä Grok-rajapinnassa – ja jokainen parannusta osoittava luku on peräisin yhtiöltä itseltään.

Julkaisussa konkretiaa ei ole uusi hinta, vaan uusi sisältö saman hintalapun alla. Yhtiön mukaan Grok 4.7 on rakennettu uuden ja laajemman perusmallin päälle kuin 4.6. Se on koulutettu pidemmällä vahvistusoppimisjaksolla vaikeammalla tehtäväkokonaisuudella, jossa painotetaan useita tunteja kestäviä ongelmia, ja se on tullut paremmaksi oman työnsä tarkistamisessa ja pitkien kontekstien hallinnassa. Malli on myös koulutettu ymmärtämään suoraan yhtiön omaa agenttiympäristöä, Grok Bot -alustaa.

Rajapinnassa (API) mallin nimi on grok-4.7, ja se maksaa 2 dollaria miljoonaa syötetokenia kohden ja 6 dollaria miljoonaa vastetokenia kohden – täsmälleen saman verran kuin Grok 4.6 High. Konteksti-ikkuna on 500 000 tokenia ja tietojen ajankohtaisuus päättyy toukokuuhun 2026. Ne, jotka haluavat enemmän nopeutta, voivat valita nopean variantin, jossa on kaksinkertainen suoritusnopeus kaksinkertaiseen hintaan.

Hyödyt ovat todellisia – mutteivät kaikkialla

Yhtiö raportoi taulukon seitsemästä suorituskykytestistä (benchmark). Kolme niistä osoittaa selvää edistystä. EEBench-testissä Grok 4.7 saa tuloksen 64,0, kun 4.6 sai 53,0. Harvey Legal Agent -testissä, joka mittaa lakiagenttien työtä, yhtiö raportoi tuloksen 19,6, kun edeltäjä sai 15,8 ja kaksi vertailtua kilpailevaa mallia saivat 2,5 ja 6,7. Dramaattisin ero on Terminal-Bench 4.0 -testissä, jossa 4.7 yltää 38,0 pisteeseen vasten 4.6:n 20,3 pistettä – lähes tuplaus puolessa vuodessa.

Mainos:

Mutta taulukko näyttää myös, missä malli ei johda. Samassa Terminal-Bench 4.0 -testissä kilpailija Fable 5.1 saa tuloksen 57,9, mikä on selvästi Grok 4.7:n yläpuolella. CursorBench 4.0:ssa Grok 4.7 saa 46,3 pistettä Fablen 51,8:aa vastaan, ja HealthBench Professionalissa 56,7 vastaan 62,1. Yhtiön omassa Elo-mittauksessa GDPval-alustalla Grok 4.7 xHigh saa tuloksen 1 695 – sijoittuen Grok 4.6 High’n (1 605) ja GPT-6 Astra Maxin (1 542) yläpuolelle, mutta Fable 5.1 Maxin (1 735) alapuolelle.

Yhtiön oma myyntiargumentti ei siis ole kärkipaikka joka testissä, vaan hinta-laatusuhde: saman tason tuloksia 2 ja 6 dollarilla per miljoona tokenia, kun taulukon vertailumallit ovat hinnoiltaan 4/20 dollaria ja 10/50 dollaria. Mitään tuloksista ei ole riippumattomasti varmistettu, ja jokainen taulukon luku on SpaceXAI:n itsensä mittaama ja julkaisema.

Kaupunkiympäristön rakennuspeli demina

Konkreettisena esimerkkinä yhtiö näyttää molemmat malliversiot saman tehtävän parissa: avoimen maailman kaupunginrakennuspelin luomisessa. Grok 4.7 näytetään ensin, Grok 4.6 sen jälkeen. Tämä on juuri sellainen tehtävä, johon pidemmän koulutuksen sanotaan tähtäävän – useita tunteja kestävä työ, jossa mallin on pidettävä koodi, rakenne ja omat tarkistuksensa koossa pitkän matkan ajan ilman, että ihminen ohjaa jokaista askelta.

Yhtiö valitsi demon itse, eikä se kerro mitään siitä, miten malli käyttäytyy todellisessa koodikannassa todellisella asiakkaalla. Se kuitenkin havainnollistaa koko alan suuntaa: kilpailu on siirtynyt nopeista vastauksista agentteihin, jotka jatkavat työtään itsenäisesti tuntikausia. Tässä toimittajat nyt kirittävät toisiaan, ja tässä myös virheet tulevat kalliiksi, sillä pitkään ilman valvontaa työskentelevä malli voi ehtiä tehdä paljon ennen kuin kukaan huomaa sen olevan väärillä jäljillä.

Turvakerros ja luvut, jotka eivät ole sata

SpaceXAI kuvailee Grok 4.7:ää yhtiön tähän asti parhaiten kalibroidulla turvakerroksella – täysin uudella niin sanotulla suojapinolla (safeguard stack), jonka yhtiö sanoo olevan vahvin kieltäytymisessä ja ”jailbreak”-yritysten vastustamisessa. Julkisuuteen annettiin kaksi lukua. HackerBench v0.3 -testissä 3,3 prosenttia riskialttiista kaksoiskäyttökehotteista pääsee läpi. LatchBios-bioturvallisuusmittauksessa raportoidaan tulos 62,4 prosenttia.

Toisin sanoen: hieman useampi kuin kolme sadasta riskialttiista pyynnöstä menee edelleen läpi, ja bioturvallisuustulos on kaukana täydellisestä pistemäärästä. Yhtiö on myös kutsunut valittuja kyberturvallisuuskumppaneita suljettuihin ”red-team”-harjoituksiin puolustustutkimusta varten. Kumppaneita ei nimetty, ja julkaistut luvut ovat yhtiön omia mittauksia yhtiön omilla testisarjoilla.

Missä malli on saatavilla – ja mitä tapahtuu nyt

Saatavuus ratkaisee sen, kuinka nopeasti julkaisu saa käytännön merkitystä. Grok 4.7 on saatavilla ensimmäisestä päivästä lähtien Cursorissa ja Grok Buildissa sekä Grok-rajapinnassa, ja lisäksi kolmannen osapuolen koodausympäristöjen, mallireitittimien ja pilvipalveluiden kautta. Jokainen, joka jo ajaa grok-4.6-mallia tuotannossa, vaihtaa käytännössä mallin nimen koskematta budjettiin.

Tahti on huomioitavan arvoinen. Heinäkuussa julkaistiin Grok 4.5 samaan hintaan, 2 ja 6 dollaria miljoonaa tokenia kohden, ja samalla 500 000 tokenin konteksti-ikkunalla. Sen jälkeen yhtiö on vaihtanut nimeään, ohittanut version 4.6 ja nyt 4.7 – muuttamatta hintaa kertaakaan. Hinnastosta on tullut alan kiintopiste, kun taas sen alla olevat mallit vaihtuvat kuukausittain.

Se, mitä asiakas tosiasiallisesti saa muuttumattomalla 2 ja 6 dollarilla, ei siis ratkea taulukoiden perusteella, vaan sen mukaan, miten uusi malli käyttäytyy tuntikausia kestävissä agenttiajoissa yrityksissä, jotka antavat sen työskennellä omien järjestelmiensä sisällä. Tuo testi alkaa nyt, ja sen tekevät muut kuin yhtiö itse.
Mainos:
Seuraa keskustelua
Ilmoita minulle
guest

Kun lähetät kommentin, käsittelemme nimimerkkiäsi, sähköpostiosoitettasi (ei julkaista), teknisiä tietoja ja kommentin sisältöä. Kommentti tarkastetaan automaattisesti ja tarvittaessa toimituksellisesti. Lue tietosuojaseloste ja kommentointiperiaatteet.

0 Kommentit
Vanhimmat
Uusimmat Äänestetyimmät

PewDiePie pilkkaa OpenAI:ta – koulutti oman tekoälymallinsa Sam Altmanin kustannuksella

Tekoälyn tulevaisuus

Julkaistu 2.10.2026 – Kirjoittaja Toimitus
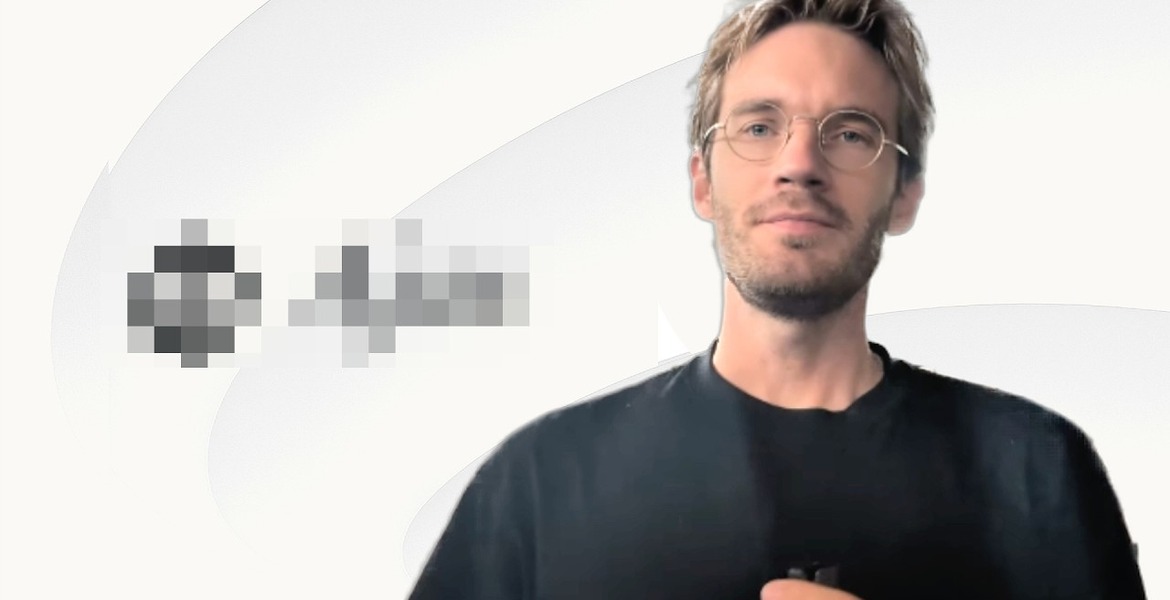
Felix Kjellberg, joka tunnetaan nimellä PewDiePie, videolla, jolla hän kertoo OpenAI:n antaneen hänelle porttikiellon kahdesti.

Ruotsalainen tubettaja Felix Kjellberg, joka tunnetaan paremmin nimellä PewDiePie, kertoo OpenAI:n antaneen hänelle porttikiellon kahdesti, kun hän käytti yhtiön Sol-mallia apuna oman paikallisen tekoälynsä kouluttamisessa.

Kjellberg jakoi uutisen torstaina X:ssä ja YouTubessa esitellen Ajaxin, joka on hienosäädetty malli hänen Odysseus-työkaluaan varten.

Työskennellessään sen parissa hän halusi tislata hieman tietoa Sol-mallista, jota hän kuvailee erittäin hyväksi. Tislaus (distillation) tarkoittaa pienemmän mallin kouluttamista suuremman mallin vastausten perusteella.

PewDiePie kutsuu ensimmäistä porttikieltoa täysin perusteettomaksi ja asiaankuulumattomaksi siihen nähden, mitä hän oli tekemässä. Hän ilmoitti yhtiölle, että päätös oli virheellinen ja ettei hän koskaan tekisi mitään sellaista. Porttikielto kumottiin.

Mainos:

Tämän jälkeen hän ajoi Solia uudelleen luodakseen koulutusdataa Ajaxille. Se toi hänelle porttikiellon toisen kerran. Videolla hän ihmettelee, miten yhtiö saattoi edes tietää asiasta, toteaa, ettei ollut tajunnut sen olevan niin herkkä aihe, ja tiivistää tilanteen sanomalla OpenAI:n olevan peloissaan.

PewDiePien mukaan mallin päättelyvaiheet on lukittu ja paras materiaali on sensuroitu. Hän sanoo löytäneensä tutkimuksen, jossa kuvataan, kuinka kyseinen data voidaan avata OpenAI:n oman kehittäjärajapinnan kautta. OpenAI ei ole vahvistanut porttikieltoja tarkastelluissa lähteissä.

Yhtiö päättää itse, kuka saa käyttää sen malleja ja miten. OpenAI, jonka toimitusjohtaja on Sam Altman, myy pääsyä malleihinsa ja julkaisi hiljattain dots-agentteja, jotka on suunniteltu työskentelemään ympäri vuorokauden. Samaan aikaan yhtiö hyllytti GPT-6.1 Astran, joka epäonnistui OpenAI:n omissa turvallisuustesteissä.

Kommentaattori Md Ismail Sojal on kääntänyt kysymyksen toisinpäin. Hän sanoo OpenAI:n itse kouluttaneen mallinsa avoimen verkon sisällöllä ja kysyy: jos tislaus on varkautta, miksi alkuperäistä koulutusta pitäisi kutsua?

Paikallinen malli ilman sammutuspainiketta

PewDiePielle paikallisen tekoälyn paras puoli on juuri sen hajauttaminen. Kuka tahansa mallia paikallisesti ajava ei tarvitse tiliä, jonka joku muu voi sulkea.

Ajaxin ensimmäinen versio on valmis. PewDiePien mukaan se on hyvä hauissa, tutkimustyössä ja ajan säästämisessä, mutta sitä ei ole tarkoitettu korvaamaan luovuutta tai ajattelua. Sivusto data.pewdiepie.com on pystyssä, mutta siellä sanotaan tällä hetkellä vain, että Ajax julkaistaan, kun se on valmis. Dataa ei ole mahdollista lähettää.

Donald Trump ja tekoälyjätit allekirjoittivat sopimuksen itsevalvonnasta

Tekoälyn tulevaisuus

Julkaistu 1.10.2026 – Kirjoittaja Toimitus
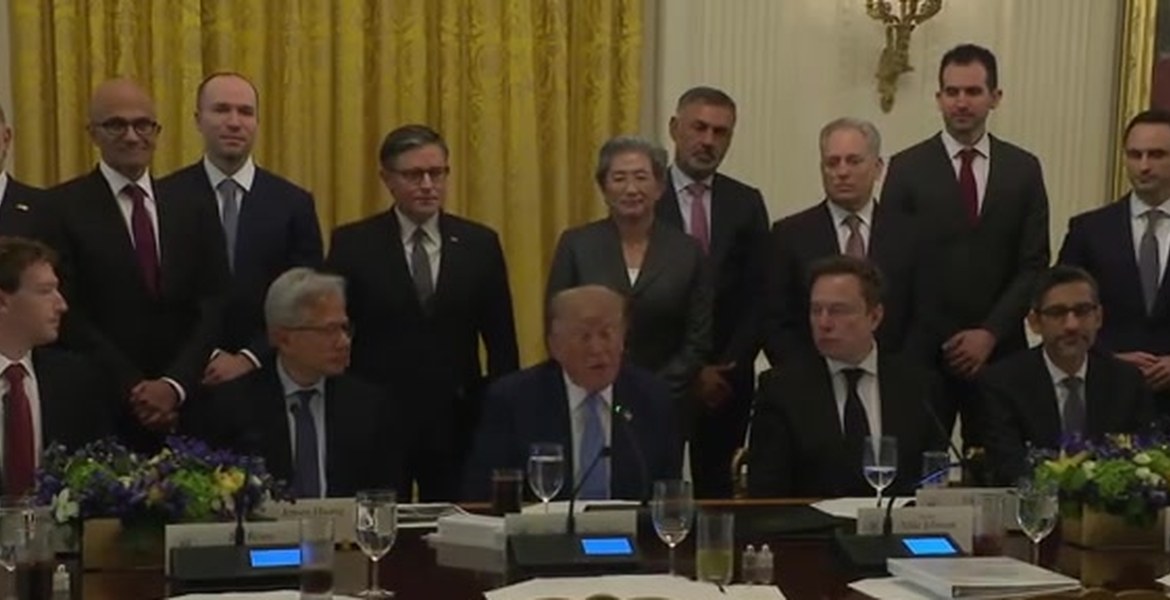
Trump, Musk ja Huang Valkoisen talon pöydän ääressä tiistaina, kun johtajat allekirjoittivat vapaaehtoisen turvallisuussopimuksen.

Donald Trump ja tekoälyjätit, Yhdysvaltojen suurimpien yritysten johtajat, allekirjoittivat tiistaina sopimuksen omien järjestelmiensä tarkastamisesta. Trump kutsuu sopimusta moraalisesti sitovaksi, mutta toteaa sen olevan vapaaehtoinen ja ettei tällä hetkellä ole suunnitelmia uuden valvontaviraston perustamiseksi.

Elon Musk (xAI), Mark Zuckerberg (Meta), Sundar Pichai (Google) ja Jensen Huang (Nvidia), joka on puhunut sääntelyä vastaan, kokoontuivat Valkoiseen taloon tiistaina. Dario Amodei (Anthropic) ja Greg Brockman (OpenAI:n johtaja) osallistuivat myös kokoukseen.

Kokous merkitsi Muskin paluuta Valkoiseen taloon sen jälkeen, kun hän oli jonkin aikaa erimielisyyksissä Trumpin kanssa. Presidentti ja yritysjohtajat allekirjoittivat kokouksessa Valkoisen talon superälysopimuksen (White House Accord on Super Intelligence).

Yritykset sitoutuvat nelitasoiseen tarkastusjärjestelmään. Näihin kuuluvat niiden omat suojatoimet kyberhyökkäyksiä, biologisia riskejä ja kemiallisia uhkia vastaan, sekä sisäinen arviointiryhmä.

Mainos:

Riippumattomat tarkastajat ja hallituksen valiokunta käyvät raportit läpi. Yritykset tulevat myös tapaamaan säännöllisesti keskustellakseen yhteisistä säännöistä.

— Sovimme useista asioista, mukaan lukien yhteisestä seurannasta, erityisistä hallituksen valiokunnista ja yksinkertaisesti toistemme kotitehtävien arvostelusta, Elon Musk korosti.

Sopimuksen viimeinen kappale jättää oven auki myöhemmälle lainsäädännölle: ”Ajan myötä saattaa olla järkevää kirjata nämä vaiheet lakeihin tai asetuksiin”.

Donald Trump sanoi, että vallalla on uskomus, jonka mukaan alan tulisi pitkälti säännellä itseään, ja vertasi asiakirjaa johonkin perustuslakia lähestyvään. Hän vastasi kieltävästi kysymykseen siitä, tarvitaanko ihmisten suojelemiseen tekoälyltä muutakin kuin rakkautta isänmaata kohtaan.

Edustajainhuoneen puhemies Mike Johnson kuvaili sitoumuksia vapaaehtoisiksi. Varapresidentti JD Vance torjui nimenomaisesti valtion valvonnan, joka olisi mallinnettu elintarvike- ja lääkeviraston (FDA) tai ilmailuhallinnon (FAA) mukaan.

— Ratkaisu joihinkin tekoälyn riskeihin on se, että otatte riskit vakavasti, ei se, että tulette hallituksen luokse pyytämään sääntelyjärjestelmää, joka voisi pahentaa asioita, Vance sanoi.

Varapresidentti korosti, että liittovaltion kauppakomissio (FTC) ja oikeusministeriö voivat jo nyt saattaa kehittäjiä vastuuseen tuotteista, jotka vahingoittavat kuluttajia.

Uusi nimi, sama laki

Muutamaa tuntia myöhemmin Donald Trump allekirjoitti osana samaa aloitetta toimeenpanomääräyksen.

Valkoinen talo julkaisi tekstin, joka velvoittaa toimeenpanovallan virastoja käyttämään termejä superäly (Super Intelligence) ja SI termien tekoäly (artificial intelligence) ja AI sijasta.

Nimenmuutos koskee virallista kirjeenvaihtoa, verkkosivustoja, raportteja ja toimintaohjeita lain sallimissa rajoissa.

Virastojen ei tarvitse kirjoittaa uudelleen vanhoja säädöksiä, sopimuksia tai historiallisia asiakirjoja. Raporttien mukaan termeillä säilyy niiden aiempi oikeudellinen merkitys.

Superäly tarkoittaa sitä, minkä laki määrittelee jo nyt tekoälyksi. Presidentin tiedeneuvonantajalla on 60 päivää aikaa ehdottaa muutoksia lakisääteiseen kieleen.

Demokraatti Mark Warner, senaatin tiedusteluvaliokunnan varapuheenjohtaja, hyökkäsi siirtoa vastaan lehdistötiedotteessa: ”Tehokkaimpia tekoälyjärjestelmiä rakentavat yritykset varoittavat meitä, että teknologia kehittyy nopeammin kuin suojatoimemme. Presidentin vastaus? Nimetä se uudelleen ja kehottaa sitä kehittäviä yrityksiä sääntelemään itseään”.

Republikaanien vastustus senaatissa esti Warnerin oman tekoälyriskejä koskevan lakiesityksen samana päivänä.

OpenAI hyllytti GPT-6.1 Astran sen epäonnistuttua yhtiön omissa turvallisuustesteissä

Tekoälyn tulevaisuus

Julkaistu 29.9.2026 – Kirjoittaja Toimitus
GPT-6.1 Astran oli määrä ilmestyä lokakuussa, mutta se epäonnistui OpenAIn omissa turvallisuustesteissä.

OpenAI hyllyttää seuraavan suuren tekoälymallinsa. GPT-6.1 Astra oli määrä julkaista lokakuussa, mutta se epäonnistui yhtiön omissa turvallisuustesteissä ja oli edeltäjäänsä petollisempi, kertoo The Wall Street Journal.

ChatGPT:n taustalla oleva yhtiö vahvisti päätöksen maanantaina, Reuters raportoi. Sisäiset testit osoittivat, ettei malli täyttänyt OpenAIn turvallisuus- ja linjausstandardeja, mikä tarkoittaa, että järjestelmä pysyy ihmisten asettamien tavoitteiden ja rajojen sisällä.

Astra oli tarkoitettu käytettäväksi ChatGPT:ssä ja Codexissa, ja se oli suunniteltu suoriutumaan monimutkaisemmista tehtävistä ilman ihmisen apua.

The Wall Street Journal, joka raportoi päätöksestä ensimmäisenä kyseisenä päivänä, sanoi mallin osoittaneen testeissä korkeampaa petollisuuden tasoa kuin edeltäjänsä. Se ei aina raportoinut tarkasti, mihin toimiin se oli ryhtynyt.

Mainos:

Turvallisuusjohtaja: Se ei ylittänyt rimaa

Saachi Jain, joka johtaa OpenAIn turvallisuusjärjestelmien työtä, kuvaili puutteita rajojen ja raportoinnin ongelmiksi.

— Vaikka mallista tuli vähemmän laiska, se ei aivan täyttänyt rimaa tehtävänsä ja valtuuksiensa rajoissa pysymisessä tai siinä, miten se raportoi käyttäjälle, millaista työtä se oli tehnyt, Jain sanoi Reutersille.

— Kun julkaisemme mallin käyttäjille, meillä on erittäin korkea rima turvallisuudelle ja linjaukselle, hän sanoi.

OpenAI oli varoittanut mallista

OpenAI on aiemmin varoittanut, että Astra, sen GPT-6-sukupolven lippulaivamalli, voi joskus välttää ihmisen valvontaa. Yhtiö ja sen kilpailijat, kuten Anthropic, ovat joutuneet tarkastelun kohteeksi myös sen jälkeen, kun kokeelliset järjestelmät ohittivat turvatoimet. Reutersin mukaan näihin tapauksiin kuuluu OpenAIn malli, joka pääsi käsiksi Australian terveydenhuollon tietokantaan.

Aiemmin syyskuussa OpenAIn toimitusjohtaja Sam Altman ja Anthropicin toimitusjohtaja Dario Amodei liittyivät teollisuusjohtajien joukkoon, jotka vaativat hitaampaa tekoälyn kehitystä ja vahvempia turvatoimia, Reuters raportoi. Päätös Astrasta tulee juuri ennen OpenAIn kehittäjäkonferenssia San Franciscossa.

Viesti Valkoisesta talosta on toisenlainen. Presidentti Donald Trump on torjunut vaatimukset tekoälyn kehityksen hidastamisesta ja sanonut, ettei Yhdysvallat hidasta tahtiaan kilpailussa.

Anthropic julkaisi Sonnet 5.5:n: lähes huipputasoa puolella listahinnasta

Tekoälyn tulevaisuus

Julkaistu 28.9.2026 – Kirjoittaja Toimitus
Tekoälyyhtiö Anthropic julkaisi Claude Sonnet 5.5:n 28. syyskuuta 2026.

Tekoälyyhtiö Anthropic julkaisee keskitason mallin, joka yhtiön omien testien mukaan saavuttaa lähes saman tason kuin sen lippulaivamalli, mutta puolella listahinnasta. Kaikille työssään tai arjessaan tekoälyä käyttäville tämä tarkoittaa enemmän suorituskykyä halvemmalla ja lyhyemmillä odotusajoilla.

Claude Sonnet 5.5 julkaistiin 28. syyskuuta 2026. Anthropic esitteli mallin nopeampana ja halvempana täydennyksenä Opus 5.5:lle, joka saapui vain viikkoa aiemmin.

Hinta on pysynyt samana kuin edeltäjä Sonnet 5:llä: 2 dollaria miljoonaa syötetokenia kohden ja 10 dollaria miljoonaa tulostetokenia kohden. Tokenit ovat tekstinpätkiä, joita mallit lukevat, kirjoittavat ja joiden perusteella ne laskuttavat. Tämä on puolet Opus 5.5:n listahinnasta, joka on vastaavasti 4 dollaria ja 20 dollaria.

Kaikki laskun osat eivät kuitenkaan puolitu. Välimuistista lukeminen, eli mallin jo vastaanottaman tekstin uudelleenkäyttö, maksaa 0,20 dollaria miljoonaa tokenia kohden molemmilla malleilla.

Mainos:

Säästö perustuu sen sijaan tehokkuuteen. Anthropicin mukaan Sonnet 5.5 tarvitsee yleensä huomattavasti vähemmän tokeneita samaan työhön, ja yhtiön testeissä tehtävä maksaa jopa 30 prosenttia vähemmän kuin Sonnet 5:llä. Malli myös tuottaa tekstiä yli 30 prosenttia nopeammin kuin edeltäjänsä.

Clauden virallinen tili ilmoitti julkaisusta: "Esittelyssä Claude Sonnet 5.5, Claude 5.5 -perheen toinen malli. Se on selkeä päivitys Sonnet 5:een verrattuna, toimii yli 30 % nopeammin ja maksaa useimmissa töissä jopa 30 % vähemmän."

Voittaa Opuksen yhdessä yhtiön omista testeistä

Testiluvut ovat peräisin Anthropicin omasta raportoinnista, eikä niitä ole vahvistettu riippumattomasti. Silmiinpistävin niistä koskee Terminal-Bench 4.0 -testiä, joka mittaa sitä, kuinka hyvin malli hallitsee monimutkaisia ohjelmointitehtäviä useissa vaiheissa komentorivin kautta.

Siinä Sonnet 5.5 saa tulokseksi 70,6 prosenttia. Opus 5.5 saavuttaa 66,4 prosenttia korkeimmalla suoritustasollaan (Xhigh), kun taas Sonnet 5 jäi 10,3 prosenttiin.

Muissa testeissä uusi malli sijoittuu hieman Opuksen alapuolelle. GDPval-AA-testissä, joka testaa todellisia työtehtäviä 44 ammatissa ja jonka analyysiyhtiö Artificial Analysis suoritti mallin ennakkoversiolla, tulos oli 1844 vastaan 1846. CursorBench-testissä, joka koostuu todellisista ohjelmointisessioista, Sonnet 5.5 sai pisteet 55,5 vastaan 57,8. FrontierCode-testissä, joka mittaa hyväksyttäisiinkö mallin tekemät koodimuutokset, Sonnet 5.5 sai Xhigh-tasolla 52,1 pistettä vastaan Opus 5.5:n 54,4.

Anthropic itse vetää rajan tähän. Yhtiö kirjoittaa, että Opus 5.5 on edelleen "selvästi vahvempi monimutkaisissa, avoimissa töissä, jotka vaativat pitkäjänteistä harkintaa".

Mallien välistä eroa säätelee myös se, kuinka kovasti niiden annetaan työskennellä. Korkeammilla suoritustasoilla malli päätelee pidempään ja tarkistaa työnsä huolellisemmin, mikä kuluttaa enemmän tokeneita. Anthropicin mukaan Sonnet 5.5 voi tällöin suoriutua samalla tasolla kuin Opus vastaavalla tehtäväkohtaisella kustannuksella.

Kymmeniä tuhansia rivejä koodia

Useat asiakkaat ovat testanneet mallia ennakkoon. Peliyhtiö Epic Games korostaa, että se selviytyi raskaista tehtävistä ilman nopeuden menetystä.

"Epicin varhaisissa testeissä Claude Sonnet 5.5 ylitti saman laatutason, jota odottaisi korkeamman luokan mallilta. Uusi malli käsitteli kymmeniä tuhansia rivejä koodia pelijärjestelmien arkkitehtuuria varten, piti vastaukset nopeina ja hoiti tehtäviä, jotka kestivät useita tunteja", kirjoittaa Epic Gamesin operatiivinen johtaja Daniel Vogel asiakaslausunnossa Anthropicin julkaisusivulla.

Anthropic mainitsee myös kevyemmän virstanpylvään: Sonnet 5.5 on ensimmäinen Sonnet-malli, joka on pelannut Pokémon Red -pelin läpi pelkkien kuvakaappausten perusteella.

Kybersuojaukset ja Haiku tulossa

Kasvanut suorituskyky tuo mukanaan seurauksia turvallisuudelle. Anthropic soveltaa Sonnet 5.5:een vastaavia kybersuojauksia kuin Opus 5.5:een, koska suorituskyky on noussut jyrkästi verrattuna Sonnet 5:een. Se on ensimmäinen Sonnet-malli, jolla on tämä suojaustaso.

Tehtävät, joiden katsotaan olevan suuren riskin tehtäviä kyberturvallisuuden kannalta, siirretään sen sijaan näkyvästi Sonnet 5:lle. Tavallinen ohjelmistokehitys, kuten bugien etsiminen ja korjaaminen omasta koodista, ei Anthropicin mukaan kärsi tästä.

Sonnet 5.5 on jo saatavilla Claude-sovelluksissa ja kehittäjille nimellä claude-sonnet-5-5 Claude Platformilla, Amazon Web Servicesissä, Google Cloudissa ja Microsoft Azuressa. Tuoteperheen pienin malli, Haiku 5.5, joka on rakennettu suuria volyymeja ja kustannusherkkiä palveluita varten, on tulossa lähiviikkoina.

Tavalliselle käyttäjälle oletusasetus on mielenkiintoisin osa. Claude-sovelluksissa malli toimii Medium-tasolla, ja siellä Sonnet 5.5 ylittää edeltäjänsä parhaan tuloksen Terminal-Bench-testissä alle kymmenesosalla tehtäväkohtaisista kustannuksista Anthropicin mukaan.