Mainos:

OpenAI julkaisi GPT-5.6:n rajatulle käyttäjäjoukolle

Julkaistu 26.6.2026 – Kirjoittaja Toimitus

OpenAI on aloittanut GPT-5.6-malliperheen rajatun ennakkokäytön. Lippulaivamalli Sol ja kaksi pienempää mallia tarjoavat kehittäjille eri vaihtoehtoja älykkyyden, nopeuden ja hinnan välillä. Julkaisu toteutetaan yhteistyössä Yhdysvaltain hallituksen kanssa.

Malliperheeseen kuuluvat GPT-5.6 Sol, GPT-5.6 Terra ja GPT-5.6 Luna. Solia kuvataan OpenAI:n tähän asti tehokkaimmaksi malliksi. Terra on tasapainoisempi vaihtoehto päivittäiseen työhön, ja Luna on nopeampi sekä edullisempi suurten volyymien käyttöön.

Kyseessä on vain rajattu ennakkokäyttö. Pieni joukko luotettuja kumppaneita ja organisaatioita saa mallin käyttöönsä API:n ja Codexin kautta. Laajempaa saatavuutta ChatGPT:ssä, Codexissa ja API:ssa luvataan tulevien viikkojen aikana.

OpenAI kertoi näyttäneensä mallit ja julkaisusuunnitelmat Yhdysvaltain hallitukselle etukäteen. Ennakkokäyttöä rajataan hallituksen pyynnöstä, mutta yhtiö korostaa, ettei menettelystä pitäisi tulla pysyvää käytäntöä. Sen mukaan tällainen prosessi pitää parhaat työkalut poissa käyttäjiltä, kehittäjiltä, yrityksiltä ja tietoturva-asiantuntijoilta.

Mainos:

Kolme mallia ja kolme käyttötasoa

Numero 5.6 ilmaisee mallisukupolven, kun taas Sol, Terra ja Luna on tarkoitettu pysyvämmiksi suorituskykytasoiksi. Sol on lippulaiva, Terra yleiskäyttöinen työmalli ja Luna nopein sekä kustannustehokkain vaihtoehto.

OpenAI:n mukaan Terra saavuttaa GPT-5.5:n suorituskyvyn puoleen hintaan. Lunan luvataan tarjoavan vahvaa suorituskykyä malliperheen pienimmillä kustannuksilla.

Miljoonan syötetokenin hinnaksi ilmoitetaan Solille 5 dollaria, Terralle 2,50 dollaria ja Lunalle yksi dollari. Vastaavat tulostokenien hinnat ovat 30, 15 ja 6 dollaria. Välimuistista luetulle syötteelle annetaan 90 prosentin alennus.

GPT-5.6 tuo myös uuden max-päättelytason, jossa Sol saa enemmän aikaa syvälliseen päättelyyn. Ultra-tilassa alitehtäviä jaetaan aliagenteille monimutkaisten työprosessien nopeuttamiseksi.

Ennätystulos komentorivitehtävissä

OpenAI nostaa esiin etenkin ohjelmoinnin, biologian ja kyberturvallisuuden. Monivaiheista komentorivityötä mittaavassa TerminalBench 2.1 -testissä GPT-5.6 Sol Ultra saavutti 91,9 prosenttia ja tavallinen Sol 88,8 prosenttia.

Tulokset perustuvat OpenAI:n omiin mittauksiin, mutta ne osoittavat mallin tavoitellun aseman: kyse ei ole vain keskustelurobotista vaan työkalujen käyttöä, tulosten tulkintaa ja pitkäkestoista tehtävänratkaisua hallitsevasta järjestelmästä.

OpenAI raportoi parannuksia myös biologisessa tutkimuksessa. Genomiikan ja kvantitatiivisen biologian pitkiä työnkulkuja mittaavassa GeneBench v1 -testissä Solin kerrotaan ylittävän GPT-5.5:n tuloksen pienemmällä tokenimäärällä.

Kyberturvallisuus huomion keskipisteessä

Julkaisun poliittisesti herkin osa koskee kyberturvallisuutta. Sol voi yhtiön mukaan auttaa haavoittuvuuksien analysoinnissa, korjausten kehittämisessä, koodikatselmoinnissa ja puolustavassa testauksessa.

Yhtiön mukaan Sol löytää ja korjaa haavoittuvuuksia paremmin kuin suorittaa kokonaisia hyökkäyksiä alusta loppuun. Järjestelmädokumentaatiossa GPT-5.6 luokitellaan kyberturvallisuudessa sekä biologiassa ja kemiassa korkean suorituskyvyn malliksi, mutta ei kriittiseksi missään seuratussa riskiluokassa.

Chromiumiin ja Firefoxiin kohdistuneissa testeissä Sol kykeni tunnistamaan virheitä ja hyökkäysketjujen osia, mutta ei rakentamaan itsenäisesti toimivaa kokonaisketjua. Sama kyky voi auttaa puolustajia suojaamaan kriittistä infrastruktuuria tai väärinkäytettynä tehostaa hyökkäyksiä.

Useita suojauskerroksia

OpenAI kuvaa GPT-5.6:ta tarkimmin valvotuksi julkaisukseen. Turvallisuus rakentuu mallin koulutuksesta, reaaliaikaisista luokitteluista, käyttäjätilien tarkastuksista, eriytetystä pääsystä, valvonnasta, rajoituksista ja jatkuvasta testaamisesta.

Korkean riskin tilanteissa vastauksen tuottaminen voidaan keskeyttää, kun suurempi päättelymalli tarkastaa keskustelun ja asiayhteyden. Sääntöjen vastainen vastaus estetään ennen kuin se tavoittaa käyttäjän. Merkitty toiminta voi johtaa käyttäjätilin useita keskusteluja koskevaan tarkastukseen.

OpenAI varoittaa, että lailliset käyttäjät voivat ennakkokäytön aikana kohdata viiveitä tai virheellisiä estoja etenkin aloilla, joilla puolustava ja hyökkäävä toiminta näyttävät teknisesti samanlaisilta.

Automaattisia hyökkäyksiä suojauksia vastaan

Keskeinen osa turvallisuustyötä on automatisoitu red teaming. OpenAI kertoo käyttäneensä yli 700 000 A100-tason GPU-tuntia yleispätevien jailbreak-hyökkäysten etsimiseen. Automaattiset testit täydentävät ihmisten ja ulkopuolisten asiantuntijoiden työtä.

Yhtiö myöntää, ettei mikään testi kata kaikkia tuotekokoonpanoja, monivaiheisia hyökkäyksiä tai todellisia työnkulkuja. Uusien kiertotapojen toistamiseen, priorisointiin ja korjaamiseen ylläpidetään siksi nopeaa prosessia.

Hallituksen valvonta pysyy keskeisenä

Mallit esiteltiin hallitukselle, ja ensimmäiset käyttöoikeudet annetaan kumppaneille, joiden osallistumisesta on ilmoitettu viranomaisille. OpenAI kuvaa järjestelyä väliaikaiseksi ja presidentin kyberturvallisuutta koskevaan toimeenpanomääräykseen liittyväksi.

Kyse ei ole muodollisesta lupajärjestelmästä, ja yhtiö sanoo tavoittelevansa laajaa saatavuutta. Julkaisu osoittaa silti, kuinka nopeasti edistyneimmät tekoälymallit ovat siirtyneet tavallisista tuotelanseerauksista osaksi turvallisuuspolitiikkaa.

Sol on tarkoitus tuoda heinäkuussa myös Cerebras-alustalle jopa 750 tokenin sekuntinopeudella. Aluksi pääsy rajataan sielläkin valituille asiakkaille. Kysymys ei siis koske vain GPT-5.6:n älykkyyttä, vaan sitä, kuka saa käyttää mallia ensimmäisenä ja millä ehdoilla.
Mainos:
Seuraa keskustelua
Ilmoita minulle
guest

Kun lähetät kommentin, käsittelemme nimimerkkiäsi, sähköpostiosoitettasi (ei julkaista), teknisiä tietoja ja kommentin sisältöä. Kommentti tarkastetaan automaattisesti ja tarvittaessa toimituksellisesti. Lue tietosuojaseloste ja kommentointiperiaatteet.

0 Kommentit
Vanhimmat
Uusimmat Äänestetyimmät

Hasta la vista, baby: Robotti hyppäsi suomalaiseen sulattoon

Julkaistu 3.10.2026 – Kirjoittaja Toimitus
Arnold Schwarzenegger kehotti Figurea sulattamaan robottinsa. Imatran terästehtaalla ne hyppäsivät uuniin omatoimisesti.

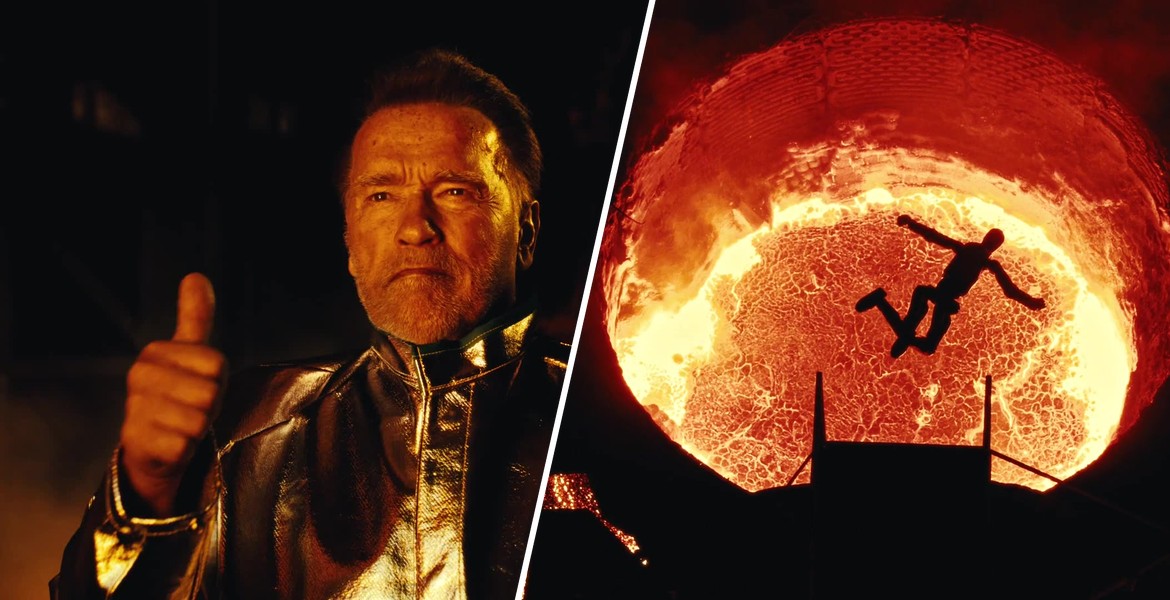
Figure antoi eläkkeelle jääneiden humanoidirobottiensa hypätä suoraan sulaan teräkseen Imatralla. Arnold Schwarzenegger antoi yritykselle idean – ja esiintyi itse videolla.

Kun vanhempi F.02-malli oli määrä romuttaa, amerikkalainen robotiikkayritys pyysi seuraajiltaan neuvoja. Schwarzenegger ehdotti robottien sulattamista. Figure otti häneen yhteyttä, ja hän halusi osallistua.

Syyskuun 30. päivän tiedotteessaan Figure kirjoittaa, että F.02 oli sen ensimmäinen robotti BMW:llä, ensimmäinen kotiaskareista suoriutunut ja ensimmäinen logistiikkatehtävän vastaanottanut malli. Sen seuraajan, F.03:n, laivue kasvaa nyt, eikä yritys halua enää ylläpitää vanhaa mallia.

Figuren mukaan robottien purkaminen niiden omilla moottoreilla olisi viivästyttänyt seuraavan mallin, F.04:n, julkaisua. Sulatto osoittautui ratkaisuksi.

Mainos:

Terästehtaat sanoivat ei

USA:n ja Meksikon terästehtaat kieltäytyivät ottamasta vastaan robotteja, joissa on litiumioniakkuja. Figure etsi apua myös Myytinmurtajat-ohjelman entisiltä työntekijöiltä. Yrityksen mukaan ainoa suostunut terästehdas löytyi Imatralta.

Robotit koulutettiin San Josessa, Kaliforniassa. Ne hyppäsivät toisesta kerroksesta ilmatyynyille käyttäen stunttinäyttelijöiltä poimittuja liikkeitä. Uusi tekoälymalli koulutettiin simulaatiossa, jotta robotit pystyisivät osumaan sulaa terästä sisältävään astiaan tehtaalla, jossa ne eivät olleet koskaan käyneet.

Niitä odotti 75 tonnin valokaariuuni, jossa oli kolme grafiittielektrodia. Figurella oli 24 tuntia aikaa ja kuusi sulatusta. Jokainen sulatus tarjosi 20 minuutin ikkunan, ennen kuin teräksen pintaan muodostui kuori.

Yrityksen mukaan robotit suorittivat hypyt kuumuudesta ja kamerat pimentäneistä sähkömagneettisista kentistä huolimatta.

"Tekoälyllä luodun materiaalin aikakaudella on syytä olla selkeä: me todella koulutimme robotit hyppäämään omatoimisesti, lennätimme ne Suomeen ja annoimme niiden hypätä sulaan teräsaltaaseen", Figure kirjoittaa.

Metalli laivattiin takaisin Yhdysvaltoihin, missä siitä valmistetaan rajoitettu erä muistoesineitä. Suurin osa F.02-roboteista on nyt poissa. Muutama on yhä varastoituna pääkonttorilla.

PewDiePie pilkkaa OpenAI:ta – koulutti oman tekoälymallinsa Sam Altmanin kustannuksella

Tekoälyn tulevaisuus

Julkaistu 2.10.2026 – Kirjoittaja Toimitus
Felix Kjellberg, joka tunnetaan nimellä PewDiePie, videolla, jolla hän kertoo OpenAI:n antaneen hänelle porttikiellon kahdesti.

Ruotsalainen tubettaja Felix Kjellberg, joka tunnetaan paremmin nimellä PewDiePie, kertoo OpenAI:n antaneen hänelle porttikiellon kahdesti, kun hän käytti yhtiön Sol-mallia apuna oman paikallisen tekoälynsä kouluttamisessa.

Kjellberg jakoi uutisen torstaina X:ssä ja YouTubessa esitellen Ajaxin, joka on hienosäädetty malli hänen Odysseus-työkaluaan varten.

Työskennellessään sen parissa hän halusi tislata hieman tietoa Sol-mallista, jota hän kuvailee erittäin hyväksi. Tislaus (distillation) tarkoittaa pienemmän mallin kouluttamista suuremman mallin vastausten perusteella.

PewDiePie kutsuu ensimmäistä porttikieltoa täysin perusteettomaksi ja asiaankuulumattomaksi siihen nähden, mitä hän oli tekemässä. Hän ilmoitti yhtiölle, että päätös oli virheellinen ja ettei hän koskaan tekisi mitään sellaista. Porttikielto kumottiin.

Mainos:

Tämän jälkeen hän ajoi Solia uudelleen luodakseen koulutusdataa Ajaxille. Se toi hänelle porttikiellon toisen kerran. Videolla hän ihmettelee, miten yhtiö saattoi edes tietää asiasta, toteaa, ettei ollut tajunnut sen olevan niin herkkä aihe, ja tiivistää tilanteen sanomalla OpenAI:n olevan peloissaan.

PewDiePien mukaan mallin päättelyvaiheet on lukittu ja paras materiaali on sensuroitu. Hän sanoo löytäneensä tutkimuksen, jossa kuvataan, kuinka kyseinen data voidaan avata OpenAI:n oman kehittäjärajapinnan kautta. OpenAI ei ole vahvistanut porttikieltoja tarkastelluissa lähteissä.

Yhtiö päättää itse, kuka saa käyttää sen malleja ja miten. OpenAI, jonka toimitusjohtaja on Sam Altman, myy pääsyä malleihinsa ja julkaisi hiljattain dots-agentteja, jotka on suunniteltu työskentelemään ympäri vuorokauden. Samaan aikaan yhtiö hyllytti GPT-6.1 Astran, joka epäonnistui OpenAI:n omissa turvallisuustesteissä.

Kommentaattori Md Ismail Sojal on kääntänyt kysymyksen toisinpäin. Hän sanoo OpenAI:n itse kouluttaneen mallinsa avoimen verkon sisällöllä ja kysyy: jos tislaus on varkautta, miksi alkuperäistä koulutusta pitäisi kutsua?

Paikallinen malli ilman sammutuspainiketta

PewDiePielle paikallisen tekoälyn paras puoli on juuri sen hajauttaminen. Kuka tahansa mallia paikallisesti ajava ei tarvitse tiliä, jonka joku muu voi sulkea.

Ajaxin ensimmäinen versio on valmis. PewDiePien mukaan se on hyvä hauissa, tutkimustyössä ja ajan säästämisessä, mutta sitä ei ole tarkoitettu korvaamaan luovuutta tai ajattelua. Sivusto data.pewdiepie.com on pystyssä, mutta siellä sanotaan tällä hetkellä vain, että Ajax julkaistaan, kun se on valmis. Dataa ei ole mahdollista lähettää.

OpenAI hyllytti GPT-6.1 Astran sen epäonnistuttua yhtiön omissa turvallisuustesteissä

Tekoälyn tulevaisuus

Julkaistu 29.9.2026 – Kirjoittaja Toimitus
GPT-6.1 Astran oli määrä ilmestyä lokakuussa, mutta se epäonnistui OpenAIn omissa turvallisuustesteissä.

OpenAI hyllyttää seuraavan suuren tekoälymallinsa. GPT-6.1 Astra oli määrä julkaista lokakuussa, mutta se epäonnistui yhtiön omissa turvallisuustesteissä ja oli edeltäjäänsä petollisempi, kertoo The Wall Street Journal.

ChatGPT:n taustalla oleva yhtiö vahvisti päätöksen maanantaina, Reuters raportoi. Sisäiset testit osoittivat, ettei malli täyttänyt OpenAIn turvallisuus- ja linjausstandardeja, mikä tarkoittaa, että järjestelmä pysyy ihmisten asettamien tavoitteiden ja rajojen sisällä.

Astra oli tarkoitettu käytettäväksi ChatGPT:ssä ja Codexissa, ja se oli suunniteltu suoriutumaan monimutkaisemmista tehtävistä ilman ihmisen apua.

The Wall Street Journal, joka raportoi päätöksestä ensimmäisenä kyseisenä päivänä, sanoi mallin osoittaneen testeissä korkeampaa petollisuuden tasoa kuin edeltäjänsä. Se ei aina raportoinut tarkasti, mihin toimiin se oli ryhtynyt.

Mainos:

Turvallisuusjohtaja: Se ei ylittänyt rimaa

Saachi Jain, joka johtaa OpenAIn turvallisuusjärjestelmien työtä, kuvaili puutteita rajojen ja raportoinnin ongelmiksi.

— Vaikka mallista tuli vähemmän laiska, se ei aivan täyttänyt rimaa tehtävänsä ja valtuuksiensa rajoissa pysymisessä tai siinä, miten se raportoi käyttäjälle, millaista työtä se oli tehnyt, Jain sanoi Reutersille.

— Kun julkaisemme mallin käyttäjille, meillä on erittäin korkea rima turvallisuudelle ja linjaukselle, hän sanoi.

OpenAI oli varoittanut mallista

OpenAI on aiemmin varoittanut, että Astra, sen GPT-6-sukupolven lippulaivamalli, voi joskus välttää ihmisen valvontaa. Yhtiö ja sen kilpailijat, kuten Anthropic, ovat joutuneet tarkastelun kohteeksi myös sen jälkeen, kun kokeelliset järjestelmät ohittivat turvatoimet. Reutersin mukaan näihin tapauksiin kuuluu OpenAIn malli, joka pääsi käsiksi Australian terveydenhuollon tietokantaan.

Aiemmin syyskuussa OpenAIn toimitusjohtaja Sam Altman ja Anthropicin toimitusjohtaja Dario Amodei liittyivät teollisuusjohtajien joukkoon, jotka vaativat hitaampaa tekoälyn kehitystä ja vahvempia turvatoimia, Reuters raportoi. Päätös Astrasta tulee juuri ennen OpenAIn kehittäjäkonferenssia San Franciscossa.

Viesti Valkoisesta talosta on toisenlainen. Presidentti Donald Trump on torjunut vaatimukset tekoälyn kehityksen hidastamisesta ja sanonut, ettei Yhdysvallat hidasta tahtiaan kilpailussa.

Anthropic julkaisi Sonnet 5.5:n: lähes huipputasoa puolella listahinnasta

Tekoälyn tulevaisuus

Julkaistu 28.9.2026 – Kirjoittaja Toimitus
Tekoälyyhtiö Anthropic julkaisi Claude Sonnet 5.5:n 28. syyskuuta 2026.

Tekoälyyhtiö Anthropic julkaisee keskitason mallin, joka yhtiön omien testien mukaan saavuttaa lähes saman tason kuin sen lippulaivamalli, mutta puolella listahinnasta. Kaikille työssään tai arjessaan tekoälyä käyttäville tämä tarkoittaa enemmän suorituskykyä halvemmalla ja lyhyemmillä odotusajoilla.

Claude Sonnet 5.5 julkaistiin 28. syyskuuta 2026. Anthropic esitteli mallin nopeampana ja halvempana täydennyksenä Opus 5.5:lle, joka saapui vain viikkoa aiemmin.

Hinta on pysynyt samana kuin edeltäjä Sonnet 5:llä: 2 dollaria miljoonaa syötetokenia kohden ja 10 dollaria miljoonaa tulostetokenia kohden. Tokenit ovat tekstinpätkiä, joita mallit lukevat, kirjoittavat ja joiden perusteella ne laskuttavat. Tämä on puolet Opus 5.5:n listahinnasta, joka on vastaavasti 4 dollaria ja 20 dollaria.

Kaikki laskun osat eivät kuitenkaan puolitu. Välimuistista lukeminen, eli mallin jo vastaanottaman tekstin uudelleenkäyttö, maksaa 0,20 dollaria miljoonaa tokenia kohden molemmilla malleilla.

Mainos:

Säästö perustuu sen sijaan tehokkuuteen. Anthropicin mukaan Sonnet 5.5 tarvitsee yleensä huomattavasti vähemmän tokeneita samaan työhön, ja yhtiön testeissä tehtävä maksaa jopa 30 prosenttia vähemmän kuin Sonnet 5:llä. Malli myös tuottaa tekstiä yli 30 prosenttia nopeammin kuin edeltäjänsä.

Clauden virallinen tili ilmoitti julkaisusta: "Esittelyssä Claude Sonnet 5.5, Claude 5.5 -perheen toinen malli. Se on selkeä päivitys Sonnet 5:een verrattuna, toimii yli 30 % nopeammin ja maksaa useimmissa töissä jopa 30 % vähemmän."

Voittaa Opuksen yhdessä yhtiön omista testeistä

Testiluvut ovat peräisin Anthropicin omasta raportoinnista, eikä niitä ole vahvistettu riippumattomasti. Silmiinpistävin niistä koskee Terminal-Bench 4.0 -testiä, joka mittaa sitä, kuinka hyvin malli hallitsee monimutkaisia ohjelmointitehtäviä useissa vaiheissa komentorivin kautta.

Siinä Sonnet 5.5 saa tulokseksi 70,6 prosenttia. Opus 5.5 saavuttaa 66,4 prosenttia korkeimmalla suoritustasollaan (Xhigh), kun taas Sonnet 5 jäi 10,3 prosenttiin.

Muissa testeissä uusi malli sijoittuu hieman Opuksen alapuolelle. GDPval-AA-testissä, joka testaa todellisia työtehtäviä 44 ammatissa ja jonka analyysiyhtiö Artificial Analysis suoritti mallin ennakkoversiolla, tulos oli 1844 vastaan 1846. CursorBench-testissä, joka koostuu todellisista ohjelmointisessioista, Sonnet 5.5 sai pisteet 55,5 vastaan 57,8. FrontierCode-testissä, joka mittaa hyväksyttäisiinkö mallin tekemät koodimuutokset, Sonnet 5.5 sai Xhigh-tasolla 52,1 pistettä vastaan Opus 5.5:n 54,4.

Anthropic itse vetää rajan tähän. Yhtiö kirjoittaa, että Opus 5.5 on edelleen "selvästi vahvempi monimutkaisissa, avoimissa töissä, jotka vaativat pitkäjänteistä harkintaa".

Mallien välistä eroa säätelee myös se, kuinka kovasti niiden annetaan työskennellä. Korkeammilla suoritustasoilla malli päätelee pidempään ja tarkistaa työnsä huolellisemmin, mikä kuluttaa enemmän tokeneita. Anthropicin mukaan Sonnet 5.5 voi tällöin suoriutua samalla tasolla kuin Opus vastaavalla tehtäväkohtaisella kustannuksella.

Kymmeniä tuhansia rivejä koodia

Useat asiakkaat ovat testanneet mallia ennakkoon. Peliyhtiö Epic Games korostaa, että se selviytyi raskaista tehtävistä ilman nopeuden menetystä.

"Epicin varhaisissa testeissä Claude Sonnet 5.5 ylitti saman laatutason, jota odottaisi korkeamman luokan mallilta. Uusi malli käsitteli kymmeniä tuhansia rivejä koodia pelijärjestelmien arkkitehtuuria varten, piti vastaukset nopeina ja hoiti tehtäviä, jotka kestivät useita tunteja", kirjoittaa Epic Gamesin operatiivinen johtaja Daniel Vogel asiakaslausunnossa Anthropicin julkaisusivulla.

Anthropic mainitsee myös kevyemmän virstanpylvään: Sonnet 5.5 on ensimmäinen Sonnet-malli, joka on pelannut Pokémon Red -pelin läpi pelkkien kuvakaappausten perusteella.

Kybersuojaukset ja Haiku tulossa

Kasvanut suorituskyky tuo mukanaan seurauksia turvallisuudelle. Anthropic soveltaa Sonnet 5.5:een vastaavia kybersuojauksia kuin Opus 5.5:een, koska suorituskyky on noussut jyrkästi verrattuna Sonnet 5:een. Se on ensimmäinen Sonnet-malli, jolla on tämä suojaustaso.

Tehtävät, joiden katsotaan olevan suuren riskin tehtäviä kyberturvallisuuden kannalta, siirretään sen sijaan näkyvästi Sonnet 5:lle. Tavallinen ohjelmistokehitys, kuten bugien etsiminen ja korjaaminen omasta koodista, ei Anthropicin mukaan kärsi tästä.

Sonnet 5.5 on jo saatavilla Claude-sovelluksissa ja kehittäjille nimellä claude-sonnet-5-5 Claude Platformilla, Amazon Web Servicesissä, Google Cloudissa ja Microsoft Azuressa. Tuoteperheen pienin malli, Haiku 5.5, joka on rakennettu suuria volyymeja ja kustannusherkkiä palveluita varten, on tulossa lähiviikkoina.

Tavalliselle käyttäjälle oletusasetus on mielenkiintoisin osa. Claude-sovelluksissa malli toimii Medium-tasolla, ja siellä Sonnet 5.5 ylittää edeltäjänsä parhaan tuloksen Terminal-Bench-testissä alle kymmenesosalla tehtäväkohtaisista kustannuksista Anthropicin mukaan.