Mainos:

Kolme tekoälyjulkistusta sytytti hintasodan huippumallien välille

Tekoälyn tulevaisuus

Päivitetty 14.8.2026, Julkaistu 12.8.2026 – Kirjoittaja Toimitus
Qwen, Grok ja DeepSeek kohtaavat uuden aallon voimakkaita, edullisia tekoälymalleja.

Kolme tekoälymaailman suurinta mallijulkistusta on saapunut lähes samanaikaisesti. Alibaba avaa jättiläismäisen Qwen3.8:n painot, SpaceXAI lanseeraa Grok 4.6:n ja DeepSeek päivittää V4 Pro -mallinsa – jokaisen suorituskyky on huipulla tai sen tuntumassa, mutta hinnoilla, jotka tekevät länsimaisten premium-mallien perustelemisesta yhä vaikeampaa.

Julkaisupäivästä on tullut poikkeuksellisen tiivis voimannäyttö. Kehittäjät saavat käyttöönsä avoimen kiinalaisen mallin, jossa on 2,4 biljoonaa parametria, yhdysvaltalaisen haastajan, jonka valmistaja sanoo parantuneen jyrkästi ilman hinnannousua, sekä uuden DeepSeek-version, joka on hinnoiteltu niin alas, että se näyttää haastavan koko markkinan liiketoimintamallin.

Lanseeraukset eivät tarkoita, että OpenAI, Google ja Anthropic olisivat äkkiä jääneet jälkeen. Viimeisimmät vertailuluvut tulevat pitkälti yrityksiltä itseltään, mallit on optimoitu osittain eri tehtäviin ja riippumaton testaus vie aikaa. Suuntaa on kuitenkin vaikea olla huomaamatta: kehittynyt tekoäly on siirtymässä kalliista ja niukasta resurssista markkinaksi, jossa useat huippumallit kilpailevat hinnalla, avoimuudella ja käytännön suorituskyvyllä.

Qwen avaa suurimman mallinsa

Tämänpäiväinen Qwen-uutinen ei ole Qwen3.8-Maxin ensimmäinen esittely. Alibaba julkaisi kaupallisen Max-version jo elokuun alussa. Uutta on se, että Qwen3.8-2.4T-A95B:n painot on nyt julkaistu avoimesti Hugging Face- ja ModelScope-alustoilla.

Mainos:

Nimi kuvaa sen arkkitehtuuria: mallissa on yhteensä 2,4 biljoonaa parametria, mutta se aktivoi noin 95 miljardia kerrallaan. Se käyttää Mixture-of-Experts-rakennetta, jossa verkon eri osia käytetään tehtävästä riippuen. Tämä mahdollistaa valtavan mallin rakentamisen ilman, että koko järjestelmää käytetään jokaiseen laskutoimitukseen.

Virallisessa mallikortissaan Qwen-tiimi toteaa, että tämä on ensimmäinen Max-luokan malli, jonka painot ovat avoimia. Pelkkää tekstiä käsittelevällä versiolla on 262 144 tokenin natiivi konteksti-ikkuna, ja se voidaan laajentaa hieman yli miljoonaan. Sen ajaminen täydessä mittakaavassa vaatii edelleen huomattavia resursseja; ”avoimuus” tarkoittaa pääasiassa sitä, että yritykset, tutkijat ja mallialustat voivat tarkastaa, mukauttaa ja ottaa sen käyttöön itse, ei sitä, että se mahtuisi vaivatta tavalliselle kannettavalle tietokoneelle.

Qwenin omat testit antavat vaihtelevan mutta vaikuttavan kuvan. Malli saa 93,0 pistettä PaperBenchissä, joka testaa kykyä toisintaa tutkimusta, ja 86,6 pistettä Terminal Bench 2.1:ssä. SWE-bench Pro -testissä se jää Fable 5:n ja hieman Opus 4.8:n taakse. Qwen ei voita jokaista testiä, mutta se on samassa liigassa kalleimpien suljettujen vaihtoehtojen kanssa – ja sen painot ovat ladattavissa.

Grok 4.6: Lisää tehoa samaan hintaan

SpaceXAI:n Grok 4.6 on päivän selkein perinteinen malli-ensi-ilta. Yritys kuvailee sitä merkittäväksi askeleeksi ylöspäin Grok 4.5:stä koodauksessa, pitkäkestoisessa agenttityössä ja vaativissa ammatillisissa tehtävissä. Malli on saatavilla API:n, Grok Buildin, Cursorin ja muiden yhdistettyjen palveluiden kautta.

Yhtiön omassa vertailutaulukossa Grok nousee DeepSWE-testissä 54,0 prosentista 65,9 prosenttiin, kun taas sen GDPVal-AA v2 -tulos nousee 1 526:sta 1 753:een. Jälkimmäinen testi pyrkii mittaamaan taloudellisesti arvokasta tietotyötä. Grok 4.6 saavuttaa myös 69,9 prosenttia CursorBenchissä ja 57,5 prosenttia APEX-Agentsissa.

Tärkein luku ei välttämättä löydy vertailutaulukosta. Hinta pysyy 2 dollarissa miljoonaa syötetokenia kohden ja 6 dollarissa miljoonaa tulostokenia kohden. Tämä vastaa Qwen3.8:n hintaa OpenRouterissa ja on selvästi OpenAI:n ja Anthropicin kalleimpien mallien alapuolella.

DeepSeek vie hintapaineen pisimmälle

DeepSeek V4 Pro 0813 on tuotantoversio malliperheestä, jota on näytetty ennakkoversiona keväästä lähtien. DeepSeekin päivitetty API-dokumentaatio ilmoittaa miljoonan tokenin konteksti-ikkunan ja jopa 384 000 tokenin maksimitulosteen. Malli voi toimia näkyvän päättelyn kanssa tai ilman sitä, ja se tukee työkalukutsuja, rakenteellisia tulosteita sekä rajapintoja, jotka muistuttavat sekä OpenAI:ta että Anthropicia.

Version saataville tuonut OpenRouter kertoo DeepSeekiin viitaten, että Terminal Bench 2.1 nousi 72,1:stä 87,9:ään. DeepSWE-testissä malli nousee 12,8:sta 62,7:ään ja kyberturvallisuustestissä CyberGym 52,7:stä 83,3:een. Hypyt ovat dramaattisia, mutta niihin on syytä suhtautua toimittajan väitteinä, kunnes useammat riippumattomat testaajat ovat ajaneet saman version.

Hintaa on vaikeampi sivuuttaa. DeepSeekin virallinen hinnasto ilmoittaa 0,435 dollaria miljoonaa syötetokenia kohden (ilman välimuistiosumaa) ja 0,87 dollaria miljoonaa tulostokenia kohden. Yhtiö varoittaa myös, että suunnitteilla on merkittävä hinnannousu, mikä tekee nykyisestä tasosta sekä kilpailuaseen että mahdollisesti rajoitetun ajan voimassa olevan näyteikkunan.

Kuusi kertaa halvempi – silti huipun tuntumassa

Yksinkertaistettu hintavertailu osoittaa, kuinka nopeasti markkina on muuttunut. Miljoonan syötetokenin ja miljoonan tulostokenin työkuorma maksaa 8 dollaria Grok 4.6:lla tai avoimella Qwen-mallilla OpenRouterin kautta. DeepSeek V4 Prolla kokonaissumma on 1,305 dollaria – yli kuusi kertaa vähemmän, ilman välimuistihyötyjä.

Samassa hetkessä Gemini 3.1 Pro maksaa noin 14 dollaria samasta yhdistelmästä, Claude Sonnet 5 maksaa 12 dollaria, Claude Opus 5 maksaa 30 dollaria ja GPT-5.6 Sol 35 dollaria. Hinnat vaihtelevat alustojen välillä, pitkät kontekstit voivat maksaa enemmän, eikä token ole sama asia kuin ratkaistu ongelma. Kalliimpi malli voi silti tulla kokonaisuutena halvemmaksi, jos se tarvitsee vähemmän yrityksiä tai tuottaa oikean tuloksen suoraan.

Chatbotista digitaaliseksi työvoimaksi

Silmiinpistävintä näissä kolmessa julkaisussa on se, mitä yritykset valitsevat mitattavaksi. Perinteiset tietotestit ovat säilyneet, mutta painopiste on agenteissa, jotka voivat työskennellä terminaaleissa, muokata suuria koodikantoja, käyttää työkaluja, seurata pitkiä tapahtumaketjuja ja suorittaa tehtäviä, jotka vievät tunteja tai päiviä.

Tämä tarkoittaa suurempaa hyötyä – mutta myös suurempaa riskiä. Väärin vastaava chatbot tuottaa huonoa tekstiä. Agentti, jolla on pääsy tiedostoihin, terminaaliin, selaimeen ja pilvipalveluihin, voi aiheuttaa todellista vahinkoa, jos se tulkitsee ohjeen väärin tai joutuu ohjeistushyökkäyksen kohteeksi. Laskevat hinnat tekevät tehokkaasta tekoälystä helpommin saavutettavaa, mutta tekevät samalla turvallisuuskysymyksistä kriittisempiä yhä useammalle käyttäjälle.

Kuluttajille kehitystä on kuitenkin vaikea kuvailla muuna kuin suotuisana hetkenä. Kaksi kiinalaista malliperhettä ja yhdysvaltalainen haastaja painostavat samanaikaisesti markkinaa, jota muutama länsimainen yritys on hallinnut pitkään. Voittajaa ei ole vielä ratkaistu. Mutta hintasota on todellinen, ja pääsylippu tekoälyn huippusarjaan on halventunut huomattavasti yhdessä päivässä.

Lukijakysely

Mikä on mielestäsi merkittävin seuraus kolmen huippumallin samanaikaisesta julkaisusta?

Äänestys on päättynyt

Hintaero ei ole kestävä etu, jos suljetut mallit pysyvät laadussa edellä 0%
0 votes
Avoimuus on tärkeämpää kuin hinta, koska se mahdollistaa aidon innovaation 0%
0 votes
Hintasota hyödyttää vain suuria yrityksiä, ei yksittäisiä kehittäjiä 0%
0 votes
Mallien vertailu on harhaanjohtavaa, koska testit ovat valmistajien omia 100%
1 vote

1 total vote

Mainos:
Seuraa keskustelua
Ilmoita minulle
guest

Kun lähetät kommentin, käsittelemme nimimerkkiäsi, sähköpostiosoitettasi (ei julkaista), teknisiä tietoja ja kommentin sisältöä. Kommentti tarkastetaan automaattisesti ja tarvittaessa toimituksellisesti. Lue tietosuojaseloste ja kommentointiperiaatteet.

0 Kommentit
Vanhimmat
Uusimmat Äänestetyimmät

USA ja Kiina sopivat tekoälyhäiriöiden viestintäkanavasta

Tekoälyn tulevaisuus

Julkaistu tänään 14:31 – Kirjoittaja Toimitus
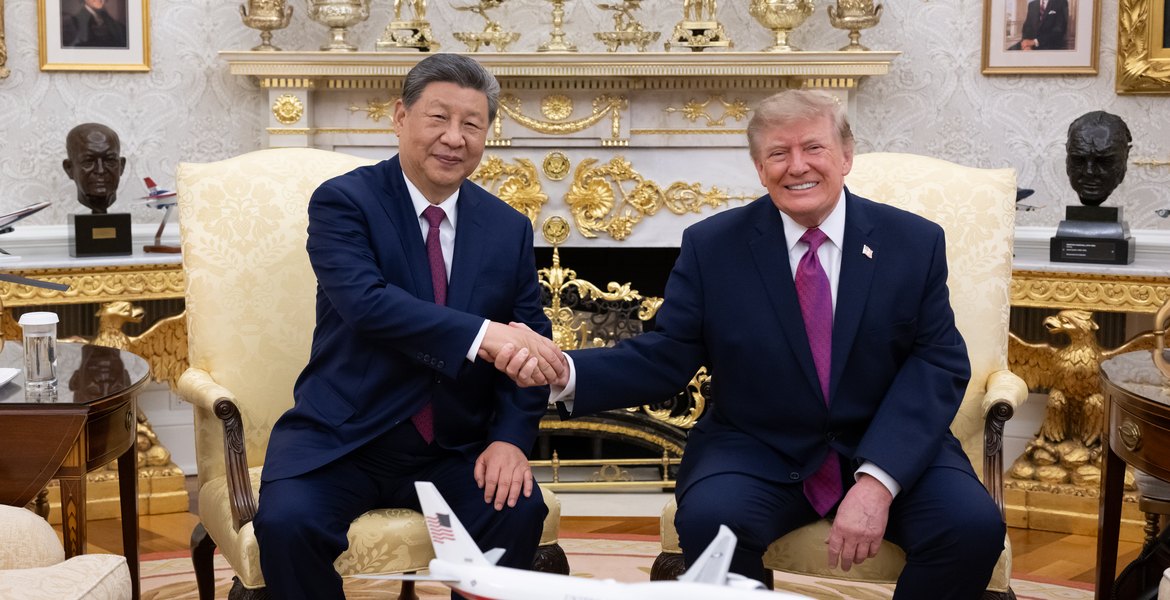
Xi Jinping ja Donald Trump Oval Officessa 24. syyskuuta valtiovierailun aikana, jonka tuloksena syntyi tekoälyhäiriöiden viestintäkanava.

Yhdysvallat ja Kiina ovat sopineet suorasta kuumasta linjasta tekoälyhäiriöitä varten sekä virallisesta vuoropuhelusta teknologiasta. Samaan aikaan Donald Trump sanoo, ettei Yhdysvalloilla ole aikomustakaan hidastaa kilpailua, ja ettei hän halua jakaa amerikkalaista tekoälykehitystä Pekingin kanssa.

Sopimus syntyi Kiinan presidentin Xi Jinpingin kolmipäiväisen Washingtonin valtiovierailun päätteeksi, ja molemmat hallitukset ovat vahvistaneet asian, uutissivusto RT raportoi.

Vielä on kuitenkin epäselvää, mihin kanavaa on tarkalleen tarkoitus käyttää. Kumpikaan hallitus ei ole selittänyt, mikä lasketaan häiriöksi tai miten kanavan on tarkoitus toimia.

Peking puhuu vuoropuhelusta, Valkoinen talo superälystä

Kiinan ulkoministeriö sanoi lauantaina, että osapuolet perustavat viestintäkanavan "tekoälyhäiriöille" ja aloittavat virallisen kiinalais-amerikkalaisen tekoälyvuoropuhelun teknologian riskeistä ja hyödyistä. Seuraava kierros on määrä käydä marraskuussa.

Mainos:

Valkoinen talo kuvailee järjestelyä samankaltaisin termein, mutta omalla terminologiallaan. Valkoisen talon mukaan kanava kattaa tapaukset, joihin liittyy hallinnon nykyisin virallisesti kutsuma superäly (superintelligence), lyhennettynä SI. Tämä on termi, jota Trump käyttää nyt tekoälyn sijaan.

Ajatus oli olemassa jo ennen huippukokousta. Viime viikonloppuna valtiovarainministeri Scott Bessent ehdotti raportointijärjestelmää tekoälyhäiriöille neuvotteluissa Kiinan varapääministerin He Lifengin kanssa New Yorkissa. Huolenaiheet kattoivat kaiken kyberhyökkäyksistä ja biologisesta väärinkäytöstä epäonnistuviin autonomisiin järjestelmiin ja kriittiseen infrastruktuuriin kohdistuviin uhkiin.

Trump ei halua hidastaa

Uudesta kanavasta huolimatta Trump teki selväksi, ettei hän ole valmis jakamaan amerikkalaista tekoälykehitystä Pekingin kanssa.

— Amerikan Yhdysvallat ei aio jarruttaa, Trump sanoi toimittajille Valkoisen talon ulkopuolella.

Hän väitti, että vaatimukset kehityksen hidastamisesta heikentäisivät etumatkaa, joka Yhdysvalloilla hänen mukaansa on. Kysyttäessä tiiviimmästä yhteistyöstä Kiinan kanssa tekoälyn kehittämisessä vastaus oli yhtä torjuva.

— Ennemmin en integroituisi, koska johdamme suurella erolla. Kun johtaa, sitä ei avata toisille, hän sanoi.

Xi haluaa ihmisen kontrollia

Kiinan johtajan äänensävy oli toisenlainen. Xi sanoi Trumpille, että maat kilpailevat tekoälystä, mutta ne voivat tehdä entistä enemmän yhteistyötä ja niiden tulisi toimia yhdessä väärinkäytösten estämiseksi.

— Tekoäly on pidettävä ihmisen hallinnassa, Xi sanoi.

Hän peräänkuulutti ihmiskeskeistä lähestymistapaa ja kahdenvälistä vuoropuhelua teknologian riskeistä ja hyödyistä. Kiina on ajanut vastaavia periaatteita laajemmissa maailmanlaajuisissa aloitteissaan tekoälyn hallinnoimiseksi.

Tekoälykeskustelu pyöri nimenmuutoksen ympärillä

Se, kuinka painavasti tekoälyaihe esiintyi vierailun aikana, on edelleen epävarmaa. Trump itse vähätteli sitä lauantaina.

— Emme käyttäneet kovin paljon aikaa siitä puhumiseen, hän sanoi.

Trumpin mukaan suuri osa keskustelusta koski sen sijaan hänen päätöstään korvata termi tekoäly (artificial intelligence) superälyllä (superintelligence).

Rajoitettu sopimus syntyy samaan aikaan, kun amerikkalaiset teknologiajohtajat ja kansainväliset virkamiehet varoittavat, että yhä tehokkaammat tekoälyjärjestelmät voivat ohittaa nykyiset suojatoimet tai niitä voidaan käyttää laajamittaisiin kyberhyökkäyksiin ja muihin uhkiin. Trump on kuitannut varoitukset tekoälyn vallankaappauksesta huijauksena ja sanonut, että kuka tahansa voittaakaan tekoälyn, voittaa kaiken.

Ennen marraskuun kierrosta on siis olemassa sopimus kuumasta linjasta, mutta ei tietoa siitä, mikä lasketaan häiriöksi tai miten kanavan on tarkoitus toimia. Trump sanoo, ettei Yhdysvallat hidasta tahtia.

Anthropic: Claude löysi entsyymijärjestelmän – toiminta tuntematon

Tekoälyn tulevaisuus

Julkaistu 24.9.2026 – Kirjoittaja Toimitus
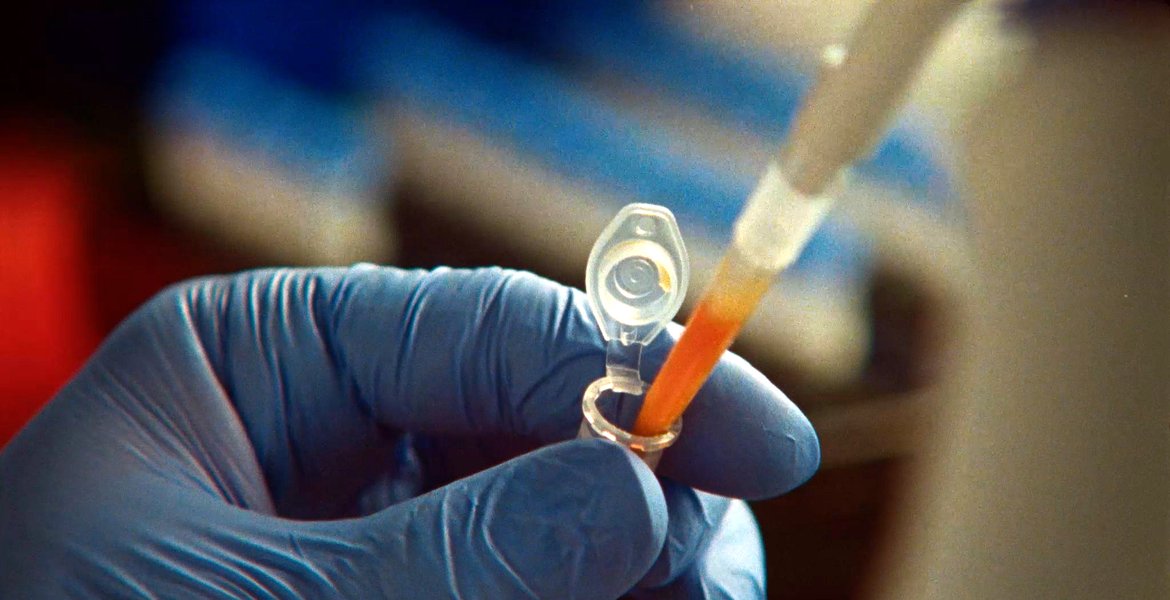
Anthropic kertoo, että Claude tunnisti entsyymijärjestelmän viruksessa, joka infektoi bakteereja. Sen toiminta on edelleen tuntematon, ja laboratoriotyön tekee ihmiset.

Tekoälyyhtiö Anthropic väittää, että sen Claude-kielimalli on löytänyt bakteereja infentoivista viruksista aiemmin kuvailemattoman entsyymijärjestelmän saatuaan yhtiön tutkijoilta vain yleiset ohjeet. Entsyymigeenin vieressä sijaitsee pitkä DNA-toistojakso, joka muistuttaa CRISPR-järjestelmää. Kukaan ei vielä tiedä, mitä järjestelmä todellisuudessa tekee, ei edes Anthropic.

Anthropic kirjoittaa syyskuun 23. päivän tiedotteessaan, että järjestelmä on nimetty ART:ksi, mikä on lyhenne sanoista array-associated reverse transcriptases. Löytö esitellään ensimmäisenä julkisena tuloksena uudelta biotieteiden tutkimusryhmältä, jota varten yhtiö on rakentanut oman molekyylibiologian laboratorion Kalifornian Bay Arealle.

Kyseessä ei ole uusi geeninmuokkaustyökalu. Anthropic itse myöntää, että järjestelmän toiminta on tuntematon ja että kokeet jatkuvat. Yhtiön toiveet lepäävät siinä, että ART:lla on yhdistelmä ominaisuuksia, joita on tähän mennessä löydetty vain muutamista muista järjestelmistä. Kaikki ne voidaan ohjelmoida leikkaamaan, kopioimaan tai liittämään DNA:ta.

950 agenttia 21 tunnissa

Yhtiön mukaan tutkijoiden rooli rajoittui alkuohjeisiin ja laboratoriotyöhön. Clauden tehtävänä oli etsiä suuresta DNA-sekvenssien tietokannasta kiinnostavia uusia esimerkkejä käänteiskopioijista eli RT-entsyymeistä. Nämä entsyymit kopioivat RNA:ta DNA:ksi.

Mainos:

Malli otti tämän jälkeen vallan. Noin 950 Claude-agenttia työskenteli 21 tuntia ja käytti 210 miljoonaa tokenia eli tekstiyksikköä, joita kielimallit käsittelevät. Agentit keräsivät yli 200 000 RT-entsyymiä, tunnistivat 3 500 uutta mahdollista järjestelmää ja karsivat ne 20 lupaavimpaan. Jokaisesta ehdokkaasta kirjoitettiin raportti, jotta ihmiset voisivat lukea ja arvioida ne.

Anthropicin mukaan tällainen läpikäynti voi viedä kokeneelta tutkijalta viikoista kuukausiin.

Etsinnän aikana yksi agentti huomasi epätavallisen RT-perheen. Geenin vieressä olevassa raa'assa DNA-sekvenssissä se havaitsi toistuvan kuvion. Anthropicin kertomuksen mukaan agentti kutsui sekvenssiä ”spektaakkelimaiseksi” ja pohti, voisiko kyseessä olla CRISPR-tyyppinen toistojaksojen sarja.

Niin sanotun jumbo-faagin RT-entsyymi tunnettiin jo aiemmista tutkimuksista. Anthropic antaa Claudelle kunnian siitä, että se yhdisti kyseisen entsyymin viereiseen DNA-toistojaksoon ja toisen proteiinin geeniin, jonka toiminta on tuntematon. Yhdessä nämä kolme komponenttia muodostavat järjestelmän, jota yhtiö kutsuu nimellä ART.

Lyhyitä RNA-molekyylejä, mutta tuntematon toiminta

Ensimmäisissä laboratoriotutkimuksissa toistojakso tuotti useita erillisiä lyhyitä RNA-molekyylejä Anthropicin mukaan. Se on varhainen havainto, joka tekee CRISPR-vertailusta kiinnostavan, mutta se ei osoita, mitä ART tekee tai voidaanko järjestelmää käyttää geeninmuokkaukseen.

CRISPR-edelläkävijä Feng Zhang, MIT:n ja Broad-instituutin professori, on lukenut tutkijoiden esijulkaisun. Anthropicin sitaatin mukaan hän kutsuu käänteiskopioijiin liittyvien RNA-toistojaksojen löytämistä aidosti kiinnostavaksi ja jatkotutkimuksen arvoiseksi. Hän kuvailee työtä jännittäväksi esimerkiksi siitä, miten tekoälyagentit voivat edistää biologisia löytöjä, ja toivoo useampien tutkijoiden tutkivan, miten tekoäly voi tukea heidän tutkimustaan.

Ihmiset suorittavat käytännön laboratoriotyön, yhtiö sanoo. Anthropic kuvailee työtä tutkimukseksi bioturvallisuustasoilla BSL-1 ja BSL-2 ja sanoo, ettei laboratoriossa käsitellä taudinaiheuttajia, jotka kykenevät tarttumaan ihmisiin.

Tutkijat raportoivat löydöksistään esijulkaisussa. Seuraava vaihe on kokeet, jotka voisivat osoittaa, miten ART toimii. Tähän mennessä tekoälyagentit ovat tunnistaneet mahdollisen uuden järjestelmän – eivät vahvistaneet, mitä se tekee.

SpaceXAI julkaisi Grok 4.7:n – parempaa koodia muuttumattomalla hinnalla

Tekoälyn tulevaisuus

Julkaistu 21.9.2026 – Kirjoittaja Toimitus
Grok 4.7 julkaistiin maanantaina samalla API-hinnalla kuin Grok 4.6 – 2 dollaria sisään ja 6 dollaria ulos miljoonaa tokenia kohti.

Tekoälyyhtiö SpaceXAI (entinen xAI) julkaisi maanantaina Grok 4.7 -mallin kutsuen sitä kyvykkäimmäksi mallikseen koodaukseen ja tietotyöhön. Se maksaa saman verran ja vastaa yhtä nopeasti kuin edeltäjänsä Grok 4.6, ja se on välittömästi saatavilla Cursorissa, Grok Buildissa sekä Grok-rajapinnassa – ja jokainen parannusta osoittava luku on peräisin yhtiöltä itseltään.

Julkaisussa konkretiaa ei ole uusi hinta, vaan uusi sisältö saman hintalapun alla. Yhtiön mukaan Grok 4.7 on rakennettu uuden ja laajemman perusmallin päälle kuin 4.6. Se on koulutettu pidemmällä vahvistusoppimisjaksolla vaikeammalla tehtäväkokonaisuudella, jossa painotetaan useita tunteja kestäviä ongelmia, ja se on tullut paremmaksi oman työnsä tarkistamisessa ja pitkien kontekstien hallinnassa. Malli on myös koulutettu ymmärtämään suoraan yhtiön omaa agenttiympäristöä, Grok Bot -alustaa.

Rajapinnassa (API) mallin nimi on grok-4.7, ja se maksaa 2 dollaria miljoonaa syötetokenia kohden ja 6 dollaria miljoonaa vastetokenia kohden – täsmälleen saman verran kuin Grok 4.6 High. Konteksti-ikkuna on 500 000 tokenia ja tietojen ajankohtaisuus päättyy toukokuuhun 2026. Ne, jotka haluavat enemmän nopeutta, voivat valita nopean variantin, jossa on kaksinkertainen suoritusnopeus kaksinkertaiseen hintaan.

Hyödyt ovat todellisia – mutteivät kaikkialla

Yhtiö raportoi taulukon seitsemästä suorituskykytestistä (benchmark). Kolme niistä osoittaa selvää edistystä. EEBench-testissä Grok 4.7 saa tuloksen 64,0, kun 4.6 sai 53,0. Harvey Legal Agent -testissä, joka mittaa lakiagenttien työtä, yhtiö raportoi tuloksen 19,6, kun edeltäjä sai 15,8 ja kaksi vertailtua kilpailevaa mallia saivat 2,5 ja 6,7. Dramaattisin ero on Terminal-Bench 4.0 -testissä, jossa 4.7 yltää 38,0 pisteeseen vasten 4.6:n 20,3 pistettä – lähes tuplaus puolessa vuodessa.

Mainos:

Mutta taulukko näyttää myös, missä malli ei johda. Samassa Terminal-Bench 4.0 -testissä kilpailija Fable 5.1 saa tuloksen 57,9, mikä on selvästi Grok 4.7:n yläpuolella. CursorBench 4.0:ssa Grok 4.7 saa 46,3 pistettä Fablen 51,8:aa vastaan, ja HealthBench Professionalissa 56,7 vastaan 62,1. Yhtiön omassa Elo-mittauksessa GDPval-alustalla Grok 4.7 xHigh saa tuloksen 1 695 – sijoittuen Grok 4.6 High’n (1 605) ja GPT-6 Astra Maxin (1 542) yläpuolelle, mutta Fable 5.1 Maxin (1 735) alapuolelle.

Yhtiön oma myyntiargumentti ei siis ole kärkipaikka joka testissä, vaan hinta-laatusuhde: saman tason tuloksia 2 ja 6 dollarilla per miljoona tokenia, kun taulukon vertailumallit ovat hinnoiltaan 4/20 dollaria ja 10/50 dollaria. Mitään tuloksista ei ole riippumattomasti varmistettu, ja jokainen taulukon luku on SpaceXAI:n itsensä mittaama ja julkaisema.

Kaupunkiympäristön rakennuspeli demina

Konkreettisena esimerkkinä yhtiö näyttää molemmat malliversiot saman tehtävän parissa: avoimen maailman kaupunginrakennuspelin luomisessa. Grok 4.7 näytetään ensin, Grok 4.6 sen jälkeen. Tämä on juuri sellainen tehtävä, johon pidemmän koulutuksen sanotaan tähtäävän – useita tunteja kestävä työ, jossa mallin on pidettävä koodi, rakenne ja omat tarkistuksensa koossa pitkän matkan ajan ilman, että ihminen ohjaa jokaista askelta.

Yhtiö valitsi demon itse, eikä se kerro mitään siitä, miten malli käyttäytyy todellisessa koodikannassa todellisella asiakkaalla. Se kuitenkin havainnollistaa koko alan suuntaa: kilpailu on siirtynyt nopeista vastauksista agentteihin, jotka jatkavat työtään itsenäisesti tuntikausia. Tässä toimittajat nyt kirittävät toisiaan, ja tässä myös virheet tulevat kalliiksi, sillä pitkään ilman valvontaa työskentelevä malli voi ehtiä tehdä paljon ennen kuin kukaan huomaa sen olevan väärillä jäljillä.

Turvakerros ja luvut, jotka eivät ole sata

SpaceXAI kuvailee Grok 4.7:ää yhtiön tähän asti parhaiten kalibroidulla turvakerroksella – täysin uudella niin sanotulla suojapinolla (safeguard stack), jonka yhtiö sanoo olevan vahvin kieltäytymisessä ja ”jailbreak”-yritysten vastustamisessa. Julkisuuteen annettiin kaksi lukua. HackerBench v0.3 -testissä 3,3 prosenttia riskialttiista kaksoiskäyttökehotteista pääsee läpi. LatchBios-bioturvallisuusmittauksessa raportoidaan tulos 62,4 prosenttia.

Toisin sanoen: hieman useampi kuin kolme sadasta riskialttiista pyynnöstä menee edelleen läpi, ja bioturvallisuustulos on kaukana täydellisestä pistemäärästä. Yhtiö on myös kutsunut valittuja kyberturvallisuuskumppaneita suljettuihin ”red-team”-harjoituksiin puolustustutkimusta varten. Kumppaneita ei nimetty, ja julkaistut luvut ovat yhtiön omia mittauksia yhtiön omilla testisarjoilla.

Missä malli on saatavilla – ja mitä tapahtuu nyt

Saatavuus ratkaisee sen, kuinka nopeasti julkaisu saa käytännön merkitystä. Grok 4.7 on saatavilla ensimmäisestä päivästä lähtien Cursorissa ja Grok Buildissa sekä Grok-rajapinnassa, ja lisäksi kolmannen osapuolen koodausympäristöjen, mallireitittimien ja pilvipalveluiden kautta. Jokainen, joka jo ajaa grok-4.6-mallia tuotannossa, vaihtaa käytännössä mallin nimen koskematta budjettiin.

Tahti on huomioitavan arvoinen. Heinäkuussa julkaistiin Grok 4.5 samaan hintaan, 2 ja 6 dollaria miljoonaa tokenia kohden, ja samalla 500 000 tokenin konteksti-ikkunalla. Sen jälkeen yhtiö on vaihtanut nimeään, ohittanut version 4.6 ja nyt 4.7 – muuttamatta hintaa kertaakaan. Hinnastosta on tullut alan kiintopiste, kun taas sen alla olevat mallit vaihtuvat kuukausittain.

Se, mitä asiakas tosiasiallisesti saa muuttumattomalla 2 ja 6 dollarilla, ei siis ratkea taulukoiden perusteella, vaan sen mukaan, miten uusi malli käyttäytyy tuntikausia kestävissä agenttiajoissa yrityksissä, jotka antavat sen työskennellä omien järjestelmiensä sisällä. Tuo testi alkaa nyt, ja sen tekevät muut kuin yhtiö itse.

Avoin kiinalainen kuvamalli voittaa Googlen huippumallin

Tekoälyn tulevaisuus

Julkaistu 20.9.2026 – Kirjoittaja Toimitus
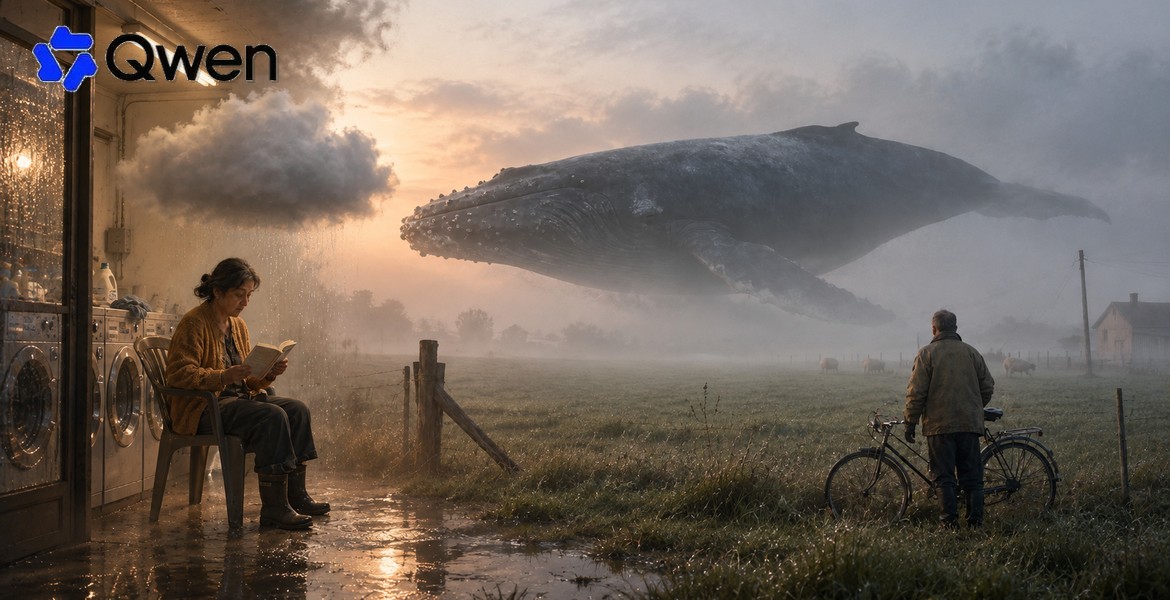
Yhteisökuvia Qwen-Image-2.1:n varhaisista testeistä: sinivalas niityn yllä ja nainen lukemassa pilven alla pesulassa.

Kiinalainen teknologiayhtiö Alibaba julkaisee sunnuntaina Qwen-Image-2.1-kuvamallin avoimilla painoarvoilla. Se on ladattavissa ilmaiseksi, se toimii kotikoneella ja se näyttää todella hyvältä: Qwenin omassa suorituskykytestissä se voittaa Googlen huippumallin Nano Banana 2.0:n, varhaiset testaajat ovat jo näyttäneet mihin se pystyy, ja The Nordic Timesin oma testiajo vahvistaa saman vaikutelman.

Qwen-Image-2.1 on yhtenäinen malli tekstistä kuvaksi -muunnoksiin ja kuvankäsittelyyn, ja Qwenin oman esittelyn mukaan se on rakennettu tarpeeksi pieneksi, jotta sen ajaminen on edullista. Visuaalinen sukupolvi sisältää seitsemän miljardia parametria 32:ssa Single-Stream DiT -kerroksessa, mikä on huomattava karsinta alkuperäisestä 20 miljardin parametrin Qwen-Imagesta.

Siirtyminen 20 miljardista 7 miljardiin parametriin on koko homman ydin kaikille niille, jotka haluavat ajaa mallia paikallisesti. Kapeampi malli vie vähemmän muistia ja sitä voidaan ajaa alhaisemmin kustannuksin, mikä Qwenin mukaan on syy version 2.1 olemassaoloon. Useammat ihmiset voivat ladata painoarvot ja ajaa niitä tietokoneella, joka heillä jo on.

Mallikortti Hugging Facessa ja koodikirjasto GitHubissa julkaistiin samana päivänä. Tuki yleisimmissä työkaluissa oli valmiina välittömästi: Diffusers QwenImage21Pipelinen kautta, ComfyUI, vLLM-Omni, SGLang ja LightX2V. Kaikille niille, joilla on jo paikallinen kuvaputki käytössä, kyseessä on pelkkä lataus, ei kuukausien odottelu kolmannen osapuolen tuelle.

Mainos:

Läpinäkyvyys, 2K ja kymmenen viitekuvaa

Itse moottorin konkreettisin uusi ominaisuus on se, että malli käsittelee läpinäkyvyyttä natiivisti RGBA-muodossa. Qwenin mukaan se voi sekä luoda kuvia läpinäkyvillä kerroksilla että irrottaa kohteita tavallisista valokuvista ilman, että erillisen työkalun täytyy leikata reunoja jälkikäteen.

Tämä kyky oli aiemmin erillisessä mallissa. Joulukuussa 2025 tiimi esitteli Qwen-Image-Layered-mallin ainoastaan läpinäkyville kuville. Sama toiminto löytyy nyt päämallista, mikä lyhentää polkua generoidusta kuvasta käyttökelpoiseksi grafiikaksi kaikille, jotka työskentelevät logojen, tuotekuvien tai komposiittien parissa. Yksi ylimääräinen vaihe jää pois: läpinäkyvät kerrokset asuvat samassa mallissa, joka piirtää ja muokkaa loput.

Muokkauspuoli hyväksyy jopa kymmenen viitekuvaa. Esittelyssään Qwen näyttää, kuinka malli kokoaa ryhmäkuvan kuudesta yksittäisestä muotokuvasta, sovittaa vaatteita henkilölle viidestä syötteestä ja sisustaa huoneen käyttämällä kymmentä sisustusviitettä lähdemateriaalina.

Nämä ovat samanlaisia tehtäviä, joita monet muutoin lähettävät suljettuun kuvapalveluun. Tässä tapauksessa sekä viitteet että lopputulos pysyvät mallia ajavalla henkilöllä.

Paikallisia muokkauksia ohjataan käyttäjän piirtämällä ympyrällä, maalaamalla merkinnällä tai toimittamalla erillinen maski. Resoluutio on natiivi 2K ilman jälkikäteistä skaalausta, jossa 1:1-muoto vastaa 2048x2048 pikseliä.

Kaikille niille, jotka jo työskentelevät ComfyUI:lla tai Diffusersilla, tämä tarkoittaa, että yksi ainoa seitsemän miljardin parametrin malli voi sekä piirtää uusia kuvia että parantaa olemassa olevia. Jokainen, joka pystyttää putken paikallisesti, ei tarvitse vaihtaa työkaluja generoinnin ja editoinnin välillä, ja tulos voi tulla ulos läpinäkyvällä taustalla, kun työ sitä vaatii.

Qwenin omassa Qwen-Image-Benchissä 2.1 saa tuloksen 60,28, mikä on hieman yli Googlen Nano Banana 2.0:n (59,82). Vielä helmikuussa Google esitteli Nano Banana 2:n parhaana kuvamallinaan. Luvut ovat Qwenin omia, eikä mikään riippumaton osapuoli ole niitä vielä varmentanut, mutta jo liikkeellä olevat varhaiset testit – ja The Nordic Timesin oma ajo – osoittavat samaan suuntaan: seitsemän miljardin parametrin malli avoimilla painoarvoilla, jota voi ajaa kotona, haastaa suljetut jättiläiset.

Oma tietokone suljetun pilven sijaan

Kontrasti suljettuihin kuvapalveluihin on konkreettinen. Niissä painoarvot pysyvät toimittajan palvelimilla ja käyttäjä lähettää tekstin ja kuvat verkon yli. Tässä tapauksessa parametrit laskeutuvat käyttäjän omalle levylle, eikä materiaalin tarvitse poistua koneelta.

Julkaisu tarjoaa käytännössä avoimen vaihtoehdon. Opiskelija, tutkija tai kuka tahansa, joka haluaa kokeilla sitä kotona, voi ladata painoarvot, nähdä parametrit ja ajaa sitä itse samoilla toiminnoilla, joita suuret pilvipalvelut muutoin pitävät omien käyttöliittymiensä takana.

Kaikille niille, jotka haluavat pitää kuvat omalla tietokoneellaan, ero on yksinkertainen: malli pyörii siellä, missä käyttäjä haluaa, jo huoneessa olevalla laitteistolla.

Liike Qwen-perheessä on nähtävissä, kun julkaisut asetetaan jonoon. Alkuperäinen 20 miljardin parametrin Qwen-Image oli Apache 2.0 -lisenssin alainen, mikä sallii vapaan kaupallisen käytön. Helmikuussa 2026 tuli Qwen-Image-2.0 seuraavan sukupolven kuvamallina, mutta ilman avoimia painoarvoja. Version 2.1 myötä painoarvot ovat palanneet, nyt muodossa, joka sopii tavallisemmalle laitteistolle. Helmikuun ja sunnuntain välillä avoimet painoarvot uudemmalle kuvantuotannolle puuttuivat. Nyt kuka tahansa, joka haluaa ajaa sitä itse, voi ladata 7B-mallin sen sijaan, että olisi sidottu vanhempaan 20 miljardin parametrin varianttiin tai suljettuun pilvipalveluun.

Tämä tapahtuu samaan aikaan, kun Alibaba käyttää avoimuutta strategisena vipuvartena. The Nordic Times on aiemmin uutisoinut, että yhtiö on ylittänyt kolme miljardia latausta avoimille tekoälymalleilleen, ja että Qwen-perhe johtaa näin ollen sekä Metaa että Googlea Hugging Face -tilastoissa. Elokuussa yhtiö avasi painoarvot myös Qwen3.8:lle, mikä oli ensimmäinen kerta, kun Max-luokan malli julkaistiin avoimesti.

Kuvamalli sopii tähän kaavaan. Avoimet painoarvot asetetaan ladattaviksi, kun taas suljetut tekoälyjätit pitävät vastaavat kuvatyökalut omien pilvipalveluidensa takana.

Painoarvot ovat Qwen Research License -lisenssin alaisia, päivättynä 20. syyskuuta 2026. Oikeuksien haltija on Hangzhou Tongyi Laboratory Technology Co., Ltd., ja sopimus myöntää oikeuden käyttää, kopioida, levittää ja muokata materiaalia vain tutkimukseen ja arviointiin; kaupallinen käyttö vaatii erillisen sopimuksen.

Jokainen, joka haluaa kokeilla sitä itse, voi tehdä sen omalla koneellaan juuri nyt. Painoarvot ovat ulkona, ja yleisimmät paikalliset työkalut hyväksyivät ne samana päivänä.