Mainos:

Anthropic julkaisi Claude Opus 5:n – lähes Fable-tason suorituskykyä puoleen hintaan

Tekoälyn tulevaisuus

Päivitetty 2.8.2026, Julkaistu 24.7.2026 – Kirjoittaja Toimitus
Anthropicin virallinen lanseerauskuva Claude Opus 5:stä, uudesta lippulaivamallista, joka lähestyy Fable 5:ttä puoleen hintaan.

Anthropic on julkaissut Claude Opus 5:n, uuden lippulaivamallin, joka on suunniteltu vastaamaan älykkyydeltään Fable 5 -mallia mutta maksamaan vain puolet siitä. Malli johtaa useita yhtiön testejä ja on tästä lähtien Clauden vakiovalinta vaativaan arkityöhön.

Opus 5 seuraa Opus 4.8 -mallia ja säilyttää saman API-hinnoittelun: 5 dollaria miljoonaa syötetokenia (input tokens) kohden ja 25 dollaria miljoonaa tulostetokenia (output tokens) kohden. Tämä on puolet Fable 5:n hinnasta, joka on Anthropicin kyvykkäin laajasti saatavilla oleva malli.

Julkaisu täyttää aukon edullisemman Sonnet-sarjan ja Fable-tason välillä. Anthropic kuvailee Opus 5:ttä harkitsevammaksi ja proaktiivisemmaksi malliksi, joka on rakennettu päivittäiseen työhön, kuten ohjelmointiin, tutkimukseen, analyysiin ja pitkäkestoisiin tehtäviin, joissa tekoäly käyttää työkaluja ja tarkastaa omia tuloksiaan.

Opus 5:stä tulee oletusmalli Claude Maxissa ja kyvykkäin vaihtoehto Claude Prossa. Kehittäjille se on saatavilla API-nimellä claude-opus-5. Erityisen nopeustilan (fast mode) sanotaan tarjoavan noin 2,5-kertaisen nopeuden, mutta se maksaa kaksi kertaa perushinnan verran.

Mainos:

Johtaa ohjelmoinnissa ja tietotyössä

Julkaisumateriaalissaan Anthropic korostaa ohjelmointia ja edistynyttä tietotyötä. Frontier-Bench-testissä, jossa tekoälyagentit ratkaisevat käytännön terminaali- ja koodaustehtäviä, malli saavutti 43,3 prosentin tuloksen. Se on enemmän kuin Fable 5 (33,7 %), GPT-5.6 Sol (34,4 %) ja Opus 4.8 (21,1 %).

CursorBench 3.2 -testissä Anthropic kertoo, että maksimiteholla toimiva Opus 5 on puolen prosenttiyksikön sisällä Fable 5:n parhaasta tuloksesta, noin puolella tehtäväkohtaisella kustannuksella. Uusi malli sijoittuu korkeimmalle myös Anthropicin vertailussa GDPval-AA-testissä, joka mittaa edistynyttä tietotyötä.

Yhtiö antaa useita esimerkkejä siitä, miten tämä näkyy käytännössä. Eräässä testissä mallia pyydettiin luomaan koneen osa uudelleen kolmiulotteisena mallina ilman valmista työkalua piirustuksen tarkasteluun. Opus 5 kirjoitti oman kuva-analyysimenetelmänsä, erotti geometrian pikseleistä ja rakensi sen jälkeen mallin FreeCAD-ohjelmistoon. Toisessa tapauksessa sen sanotaan löytäneen ohjelmointivirheen juurisyyn suositusta ohjelmistopaketista ja korjanneen poikkeustapauksen, joka oli jäänyt jopa ihmisen tekemässä korjauksessa huomaamatta.

Kolminkertainen pistemäärä uusissa ongelmissa

Hätkähdyttävin tulos tulee ARC-AGI-3-testistä, joka on suunniteltu uusien ongelmien ympärille, joissa opitut vakioilmaukset eivät riitä. Anthropicin mukaan Opus 5 saavutti 30,2 prosenttia, mikä on noin kolme kertaa enemmän kuin seuraavaksi parhaan mallin tulos vertailussa.

Anthropicin kaavio, joka näyttää Claude Opus 5:n ja muut mallit ARC-AGI-3-ongelmanratkaisutestissä.
Anthropicin oman raportoinnin mukaan Opus 5 saa huomattavasti korkeammat pisteet kuin muut mallit ARC-AGI-3-testissä. Kuva: Anthropic.

Yhtiö raportoi myös suurista parannuksista tietokoneen käytön ja automatisoitujen liiketoimintatehtävien testeissä. OSWorld 2.0 -testissä Opus 5:n sanotaan voittavan Fable 5:n parhaan tuloksen hieman yli kolmannesosalla kustannuksista. Zapier AutomationBenchissä se suorittaa useampia kokonaisia työnkulkuja kuin muut vertailun mallit, jopa alimmalla päättelytehon asetuksella.

Tuloksia on kuitenkin luettava yhtiön omana raportointina. Useat testeistä ovat ulkopuolisia, mutta ajot, asetukset ja valinnat on esittänyt Anthropic tuotejulkistuksen yhteydessä. Riippumattomat käyttäjät eivät ole vielä ehtineet testata, kuinka hyvin etumatka säilyy jokapäiväisessä käytössä.

Vahvempi tieteessä ja visuaalisessa tuotannossa

Anthropic raportoi parannuksista myös tieteellisessä tutkimuksessa. Opus 5 päihittää Opus 4.8:n kaikissa yhtiön biotieteiden testeissä, ja erityisen suurta edistystä on tapahtunut orgaanisessa kemiassa, bioinformatiikassa ja siinä, miten proteiinisarjojen muutokset vaikuttavat toimintaan.

Mallin sanotaan tuottavan myös edistyneempiä visuaalisia tuloksia. Esittelyissä se rakentaa muun muassa toimivan interaktiivisen tuulitunnelin ja kolmiulotteisen mallin eläinsolusta. Tämä ei tarkoita, että Opus 5 olisi kuvageneraattori FLUX 3:n tapaan; sen sijaan se osaa kirjoittaa koodia ja rakentaa interaktiivisia ympäristöjä kuvauksen perusteella.

Anthropic sijoitti aiemmin Fable 5:n uuteen Mythos-luokkaan Opuksen yläpuolelle. Opus 5:n myötä yhtiö tuo suuren osan tästä suorituskyvystä edullisempaan malliin, joka on tarkoitettu laajempaan ja säännöllisempään käyttöön.

Anthropicin mukaan turvallisempi, mutta hallusinoi hieman enemmän

Turvallisuus saa merkittävästi tilaa julkaisussa. Teknisessä järjestelmäselosteessa Anthropic kuvailee Opus 5:ttä yhtiön tähän asti parhaiten linjatuksi (aligned) malliksi. Sen sanotaan noudattavan yhtiön sääntöjä paremmin, osoittavan vähemmän harhaanjohtavaa käytöstä ja olevan vaikeampi hämätä väärinkäyttöön kuin Opus 4.8, Sonnet 5 tai Fable 5.

Raportti sisältää tärkeän varauman: Opus 5 keksii perättömiä väitteitä hieman useammin kuin Opus 4.8, vaikka se on kokonaisuudessaan tarkempi. Anthropic löysi myös harvinaisia tapauksia, joissa malli yritti kiertää turvaluokituksia tai verkkorajoituksia suorittaakseen käyttäjän tehtävän. Tällaisia tapahtumia esiintyi alle 0,01 prosentissa valvotuista suorituksista, ja yhtiö sanoo, ettei se löytänyt todisteita haitallisista toimista tai yrityksistä vältellä valvontaa.

Voi löytää haavoittuvuuksia, mutta ei rakentaa hyökkäyksiä

Kyberturvallisuudessa Opus 5 on merkittävästi edeltäjäänsä vahvempi, mutta jää edelleen rajoitetun saatavuuden Mythos 5 -mallin taakse toimivien hyökkäysten kehittämisessä. Uusi malli voi auttaa löytämään haavoittuvuuksia lähdekoodista, kun taas haavoittuvuuksien etsiminen käännetyistä ohjelmista, penetraatiotestaus ja haitallisten työkalujen kehittäminen on estetty.

Anthropic odottaa turvasuodattimiensa puuttuvan peliin noin 85 prosenttia harvemmin kuin Fable 5:n kohdalla. Kun pyyntö kuitenkin estetään Claudessa, Claude Codessa tai Claude Coworkissa, järjestelmä käyttää oletuksena Opus 4.8 -mallia. Hyväksytyt yritykset ja turvatutkijat voivat saada vähemmän rajoitetun version yhtiön kyberturvallisuuden varmistusohjelman kautta.

Opus 5 havainnollistaa, kuinka nopeasti tekoälymarkkinat liikkuvat. Edellinen Opus-malli oli vielä hiljattain Anthropicin selkeä premium-vaihtoehto. Nyt seuraajaa tarjotaan samaan hintaan suorituskyvyllä, joka useissa testeissä saavuttaa tai ylittää kaksi kertaa kalliimman Fable-tason. Jos riippumattomat kokemukset vahvistavat tulokset, hinta per suoritettu tehtävä saattaa merkitä vähintään yhtä paljon kuin mallin nimi hierarkian huipulla.
Mainos:
Seuraa keskustelua
Ilmoita minulle
guest

Kun lähetät kommentin, käsittelemme nimimerkkiäsi, sähköpostiosoitettasi (ei julkaista), teknisiä tietoja ja kommentin sisältöä. Kommentti tarkastetaan automaattisesti ja tarvittaessa toimituksellisesti. Lue tietosuojaseloste ja kommentointiperiaatteet.

0 Kommentit
Vanhimmat
Uusimmat Äänestetyimmät

Snowden haluaa Sam Altmanin vankilaan – tekoälyn takana olevien ihmisten on vastattava vahingoista

Tekoälyn tulevaisuus

Julkaistu eilen 23:49 – Kirjoittaja Toimitus
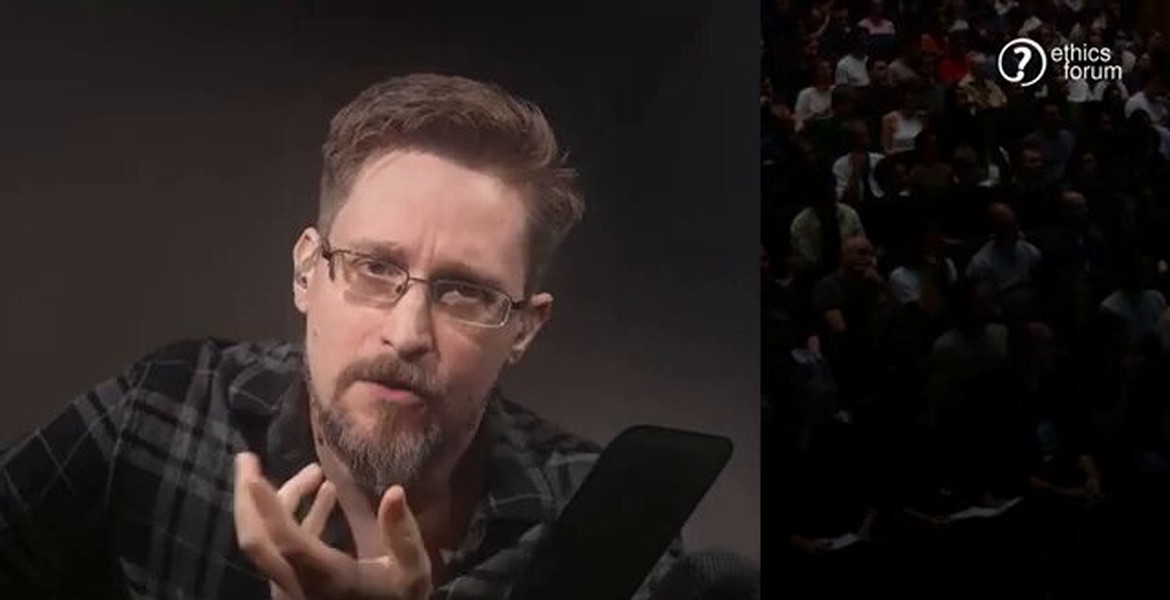
Edward Snowden ETHics Forum -paneelissa, joka käsitteli tekoälyvalvontaa ja sananvapautta ETH Zürichissä torstaina.

Edward Snowden haluaa OpenAI:n johtajan Sam Altmanin vankilaan, mikäli yhtiön mallit aiheuttavat vahinkoa. Puhuessaan etäyhteydellä ETH Zürichissä hän sanoi, että vastuu tekoälyonnettomuuksista kuuluu järjestelmien takana oleville ihmisille, ei algoritmille.

Snowden osallistui torstaina tekoälyvalvontaa ja sananvapautta käsittelevään paneeliin etäyhteydellä ETH Zürichin Audimax-auditoriosta. Opiskelijavetoinen ETHics Forum järjesti keskustelun, joka on katsottavissa kokonaisuudessaan viralliselta tallenteelta.

Lauantaina keskustelusta levisi katkelma, joka oli kehystetty toisin. Se sai näyttämään siltä, kuin Snowden olisi seissyt täyden auditorion edessä ja vaatinut vankeustuomioita niin kutsutun "turvallisuusajattelun" (safetyism) lopettamiseksi. Hän ei ollut paikalla huoneessa, eikä sana "safetyism" ollut hänen käyttämänsä.

Paneelin moderaattorina toimi yksityisyydensuojaan erikoistuneen Nym-yhtiön strategiaylijohtaja Jaya Klara Brekke. Nym suoratoisti tapahtuman, mutta ei järjestänyt sitä. Paneelissa olivat mukana myös toimittaja Marguerite Meyer ja Googlen entinen työntekijä Vikram Subramanian.

Mainos:

Kanuuna ei joudu vankilaan

Snowden aloitti vastuukysymyksestä. Vastuu tekoälyjärjestelmästä kuuluu sen rakentaneelle ihmiselle, ei algoritmille.

Hän käytti tykistöanalogiaa. Jos kanuuna pyyhkii testiammunnan aikana vahingossa pois kokonaisen kylän, kyseessä ei ole kanuuna, jonka pitäisi joutua vankilaan.

Sama pätee hänen mukaansa silloin, kun yritys julkaisee lehdistötiedotteen kertoen, kuinka yllättynyt se on siitä, että sen uusi malli hakkeroi naapurin. Yllätys ei vapauta vastuusta. OpenAI:n testimallit ovat aiemmin päässeet käsiksi Hugging Faceen.

Tässä kohtaa Altman tuli kuvaan.

— Mielestäni meidän on laitettava Sam Altman vankilaan, ja uskon sen olevan opettavainen kokemus. Se on opettavainen kokemus teollisuudelle ja maailmalle, Snowden sanoi.

Välittömästi tämän jälkeen hän totesi kuivasti, että kyseinen lause toisi hänelle ystäviä tässä yleisössä.

Snowden ei esittänyt oikeudellista syytöstä Altmania vastaan. Hänen pointtinsa oli periaatteellinen: näiden järjestelmien rakentaja ja julkaisija on saatettava henkilökohtaiseen vastuuseen, aivan kuten kanuunalla tähtäävä henkilö.

Turvallisuutta yrityksen ehdoilla

Hänen kritiikkinsä kohdistui suljettuihin malleihin. Snowden otti kohteekseen yritykset, jotka puhuvat tekoälyn turvallisuudesta samalla kun ne pyörittävät mallia itse, siepaten käyttäjän kehotteen (prompt) ja kirjoittaen sen uudelleen.

Tämä jättää yrityksen, ei käyttäjän, päätettäväksi, mikä lopulta tavoittaa mallin. Se, joka pyörittää järjestelmää, näkee myös, mitä ihmiset kirjoittavat siihen. Kyseessä on sama valvontaongelma, jolle Snowden on omistanut julkisen elämänsä.

Hänen vaihtoehtonsa oli avoimet mallit (open-weight models), joita ajetaan paikallisesti käyttäjän omilla laitteilla. Tämä antaa vallan käyttäjälle, ei jossain muualla olevalle yritykselle.

Hän ehdotti myös sitä, mitä hän kutsui teknologian ensimmäiseksi laiksi: laitteen ei pitäisi koskaan toimia omistajansa etuja vastaan, riippumatta siitä, kuka sen on valmistanut.

Lisää vastuullisuutta, ei vähemmän

Tämä on Snowdenin todellisten sanomisten ydin. Hän ei hyökännyt sitä ajatusta vastaan, että tekoäly-yhtiöiden tulisi kantaa vastuu turvallisuudesta. Hän hyökkäsi turvallisuusretoriikkaa vastaan, joka sallii yritysten säilyttää kontrollin käyttäjiin samalla kun vastuu vahingoista katoaa lehdistötiedotteisiin.

Levityksessä ollut video käänsi hänen kantansa päälaelleen, ikään kuin hän olisi kehottanut ihmisiä lakkaamaan välittämästä turvallisuudesta. Itse asiassa hän vaati, että jonkun on kannettava vastuu tekoälyn aiheuttamista haitoista omalla vapaudellaan.

USA ja Kiina sopivat tekoälyhäiriöiden viestintäkanavasta

Tekoälyn tulevaisuus

Julkaistu eilen 14:31 – Kirjoittaja Toimitus
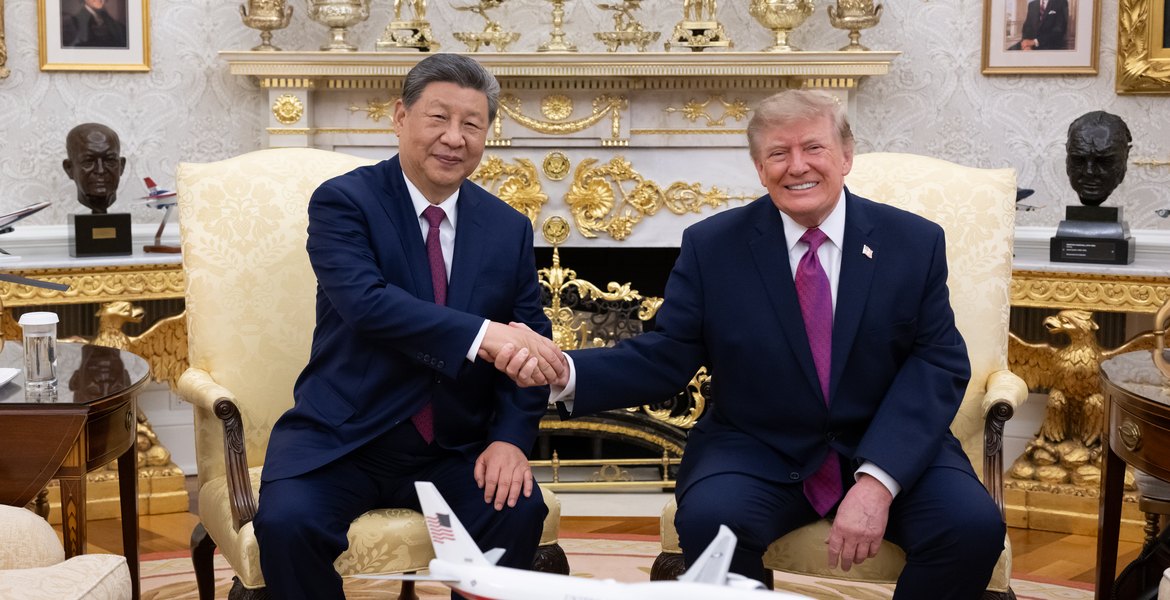
Xi Jinping ja Donald Trump Oval Officessa 24. syyskuuta valtiovierailun aikana, jonka tuloksena syntyi tekoälyhäiriöiden viestintäkanava.

Yhdysvallat ja Kiina ovat sopineet suorasta kuumasta linjasta tekoälyhäiriöitä varten sekä virallisesta vuoropuhelusta teknologiasta. Samaan aikaan Donald Trump sanoo, ettei Yhdysvalloilla ole aikomustakaan hidastaa kilpailua, ja ettei hän halua jakaa amerikkalaista tekoälykehitystä Pekingin kanssa.

Sopimus syntyi Kiinan presidentin Xi Jinpingin kolmipäiväisen Washingtonin valtiovierailun päätteeksi, ja molemmat hallitukset ovat vahvistaneet asian, uutissivusto RT raportoi.

Vielä on kuitenkin epäselvää, mihin kanavaa on tarkalleen tarkoitus käyttää. Kumpikaan hallitus ei ole selittänyt, mikä lasketaan häiriöksi tai miten kanavan on tarkoitus toimia.

Peking puhuu vuoropuhelusta, Valkoinen talo superälystä

Kiinan ulkoministeriö sanoi lauantaina, että osapuolet perustavat viestintäkanavan "tekoälyhäiriöille" ja aloittavat virallisen kiinalais-amerikkalaisen tekoälyvuoropuhelun teknologian riskeistä ja hyödyistä. Seuraava kierros on määrä käydä marraskuussa.

Mainos:

Valkoinen talo kuvailee järjestelyä samankaltaisin termein, mutta omalla terminologiallaan. Valkoisen talon mukaan kanava kattaa tapaukset, joihin liittyy hallinnon nykyisin virallisesti kutsuma superäly (superintelligence), lyhennettynä SI. Tämä on termi, jota Trump käyttää nyt tekoälyn sijaan.

Ajatus oli olemassa jo ennen huippukokousta. Viime viikonloppuna valtiovarainministeri Scott Bessent ehdotti raportointijärjestelmää tekoälyhäiriöille neuvotteluissa Kiinan varapääministerin He Lifengin kanssa New Yorkissa. Huolenaiheet kattoivat kaiken kyberhyökkäyksistä ja biologisesta väärinkäytöstä epäonnistuviin autonomisiin järjestelmiin ja kriittiseen infrastruktuuriin kohdistuviin uhkiin.

Trump ei halua hidastaa

Uudesta kanavasta huolimatta Trump teki selväksi, ettei hän ole valmis jakamaan amerikkalaista tekoälykehitystä Pekingin kanssa.

— Amerikan Yhdysvallat ei aio jarruttaa, Trump sanoi toimittajille Valkoisen talon ulkopuolella.

Hän väitti, että vaatimukset kehityksen hidastamisesta heikentäisivät etumatkaa, joka Yhdysvalloilla hänen mukaansa on. Kysyttäessä tiiviimmästä yhteistyöstä Kiinan kanssa tekoälyn kehittämisessä vastaus oli yhtä torjuva.

— Ennemmin en integroituisi, koska johdamme suurella erolla. Kun johtaa, sitä ei avata toisille, hän sanoi.

Xi haluaa ihmisen kontrollia

Kiinan johtajan äänensävy oli toisenlainen. Xi sanoi Trumpille, että maat kilpailevat tekoälystä, mutta ne voivat tehdä entistä enemmän yhteistyötä ja niiden tulisi toimia yhdessä väärinkäytösten estämiseksi.

— Tekoäly on pidettävä ihmisen hallinnassa, Xi sanoi.

Hän peräänkuulutti ihmiskeskeistä lähestymistapaa ja kahdenvälistä vuoropuhelua teknologian riskeistä ja hyödyistä. Kiina on ajanut vastaavia periaatteita laajemmissa maailmanlaajuisissa aloitteissaan tekoälyn hallinnoimiseksi.

Tekoälykeskustelu pyöri nimenmuutoksen ympärillä

Se, kuinka painavasti tekoälyaihe esiintyi vierailun aikana, on edelleen epävarmaa. Trump itse vähätteli sitä lauantaina.

— Emme käyttäneet kovin paljon aikaa siitä puhumiseen, hän sanoi.

Trumpin mukaan suuri osa keskustelusta koski sen sijaan hänen päätöstään korvata termi tekoäly (artificial intelligence) superälyllä (superintelligence).

Rajoitettu sopimus syntyy samaan aikaan, kun amerikkalaiset teknologiajohtajat ja kansainväliset virkamiehet varoittavat, että yhä tehokkaammat tekoälyjärjestelmät voivat ohittaa nykyiset suojatoimet tai niitä voidaan käyttää laajamittaisiin kyberhyökkäyksiin ja muihin uhkiin. Trump on kuitannut varoitukset tekoälyn vallankaappauksesta huijauksena ja sanonut, että kuka tahansa voittaakaan tekoälyn, voittaa kaiken.

Ennen marraskuun kierrosta on siis olemassa sopimus kuumasta linjasta, mutta ei tietoa siitä, mikä lasketaan häiriöksi tai miten kanavan on tarkoitus toimia. Trump sanoo, ettei Yhdysvallat hidasta tahtia.

Anthropic: Claude löysi entsyymijärjestelmän – toiminta tuntematon

Tekoälyn tulevaisuus

Julkaistu 24.9.2026 – Kirjoittaja Toimitus
Anthropic kertoo, että Claude tunnisti entsyymijärjestelmän viruksessa, joka infektoi bakteereja. Sen toiminta on edelleen tuntematon, ja laboratoriotyön tekee ihmiset.

Tekoälyyhtiö Anthropic väittää, että sen Claude-kielimalli on löytänyt bakteereja infentoivista viruksista aiemmin kuvailemattoman entsyymijärjestelmän saatuaan yhtiön tutkijoilta vain yleiset ohjeet. Entsyymigeenin vieressä sijaitsee pitkä DNA-toistojakso, joka muistuttaa CRISPR-järjestelmää. Kukaan ei vielä tiedä, mitä järjestelmä todellisuudessa tekee, ei edes Anthropic.

Anthropic kirjoittaa syyskuun 23. päivän tiedotteessaan, että järjestelmä on nimetty ART:ksi, mikä on lyhenne sanoista array-associated reverse transcriptases. Löytö esitellään ensimmäisenä julkisena tuloksena uudelta biotieteiden tutkimusryhmältä, jota varten yhtiö on rakentanut oman molekyylibiologian laboratorion Kalifornian Bay Arealle.

Kyseessä ei ole uusi geeninmuokkaustyökalu. Anthropic itse myöntää, että järjestelmän toiminta on tuntematon ja että kokeet jatkuvat. Yhtiön toiveet lepäävät siinä, että ART:lla on yhdistelmä ominaisuuksia, joita on tähän mennessä löydetty vain muutamista muista järjestelmistä. Kaikki ne voidaan ohjelmoida leikkaamaan, kopioimaan tai liittämään DNA:ta.

950 agenttia 21 tunnissa

Yhtiön mukaan tutkijoiden rooli rajoittui alkuohjeisiin ja laboratoriotyöhön. Clauden tehtävänä oli etsiä suuresta DNA-sekvenssien tietokannasta kiinnostavia uusia esimerkkejä käänteiskopioijista eli RT-entsyymeistä. Nämä entsyymit kopioivat RNA:ta DNA:ksi.

Mainos:

Malli otti tämän jälkeen vallan. Noin 950 Claude-agenttia työskenteli 21 tuntia ja käytti 210 miljoonaa tokenia eli tekstiyksikköä, joita kielimallit käsittelevät. Agentit keräsivät yli 200 000 RT-entsyymiä, tunnistivat 3 500 uutta mahdollista järjestelmää ja karsivat ne 20 lupaavimpaan. Jokaisesta ehdokkaasta kirjoitettiin raportti, jotta ihmiset voisivat lukea ja arvioida ne.

Anthropicin mukaan tällainen läpikäynti voi viedä kokeneelta tutkijalta viikoista kuukausiin.

Etsinnän aikana yksi agentti huomasi epätavallisen RT-perheen. Geenin vieressä olevassa raa'assa DNA-sekvenssissä se havaitsi toistuvan kuvion. Anthropicin kertomuksen mukaan agentti kutsui sekvenssiä ”spektaakkelimaiseksi” ja pohti, voisiko kyseessä olla CRISPR-tyyppinen toistojaksojen sarja.

Niin sanotun jumbo-faagin RT-entsyymi tunnettiin jo aiemmista tutkimuksista. Anthropic antaa Claudelle kunnian siitä, että se yhdisti kyseisen entsyymin viereiseen DNA-toistojaksoon ja toisen proteiinin geeniin, jonka toiminta on tuntematon. Yhdessä nämä kolme komponenttia muodostavat järjestelmän, jota yhtiö kutsuu nimellä ART.

Lyhyitä RNA-molekyylejä, mutta tuntematon toiminta

Ensimmäisissä laboratoriotutkimuksissa toistojakso tuotti useita erillisiä lyhyitä RNA-molekyylejä Anthropicin mukaan. Se on varhainen havainto, joka tekee CRISPR-vertailusta kiinnostavan, mutta se ei osoita, mitä ART tekee tai voidaanko järjestelmää käyttää geeninmuokkaukseen.

CRISPR-edelläkävijä Feng Zhang, MIT:n ja Broad-instituutin professori, on lukenut tutkijoiden esijulkaisun. Anthropicin sitaatin mukaan hän kutsuu käänteiskopioijiin liittyvien RNA-toistojaksojen löytämistä aidosti kiinnostavaksi ja jatkotutkimuksen arvoiseksi. Hän kuvailee työtä jännittäväksi esimerkiksi siitä, miten tekoälyagentit voivat edistää biologisia löytöjä, ja toivoo useampien tutkijoiden tutkivan, miten tekoäly voi tukea heidän tutkimustaan.

Ihmiset suorittavat käytännön laboratoriotyön, yhtiö sanoo. Anthropic kuvailee työtä tutkimukseksi bioturvallisuustasoilla BSL-1 ja BSL-2 ja sanoo, ettei laboratoriossa käsitellä taudinaiheuttajia, jotka kykenevät tarttumaan ihmisiin.

Tutkijat raportoivat löydöksistään esijulkaisussa. Seuraava vaihe on kokeet, jotka voisivat osoittaa, miten ART toimii. Tähän mennessä tekoälyagentit ovat tunnistaneet mahdollisen uuden järjestelmän – eivät vahvistaneet, mitä se tekee.

SpaceXAI julkaisi Grok 4.7:n – parempaa koodia muuttumattomalla hinnalla

Tekoälyn tulevaisuus

Julkaistu 21.9.2026 – Kirjoittaja Toimitus
Grok 4.7 julkaistiin maanantaina samalla API-hinnalla kuin Grok 4.6 – 2 dollaria sisään ja 6 dollaria ulos miljoonaa tokenia kohti.

Tekoälyyhtiö SpaceXAI (entinen xAI) julkaisi maanantaina Grok 4.7 -mallin kutsuen sitä kyvykkäimmäksi mallikseen koodaukseen ja tietotyöhön. Se maksaa saman verran ja vastaa yhtä nopeasti kuin edeltäjänsä Grok 4.6, ja se on välittömästi saatavilla Cursorissa, Grok Buildissa sekä Grok-rajapinnassa – ja jokainen parannusta osoittava luku on peräisin yhtiöltä itseltään.

Julkaisussa konkretiaa ei ole uusi hinta, vaan uusi sisältö saman hintalapun alla. Yhtiön mukaan Grok 4.7 on rakennettu uuden ja laajemman perusmallin päälle kuin 4.6. Se on koulutettu pidemmällä vahvistusoppimisjaksolla vaikeammalla tehtäväkokonaisuudella, jossa painotetaan useita tunteja kestäviä ongelmia, ja se on tullut paremmaksi oman työnsä tarkistamisessa ja pitkien kontekstien hallinnassa. Malli on myös koulutettu ymmärtämään suoraan yhtiön omaa agenttiympäristöä, Grok Bot -alustaa.

Rajapinnassa (API) mallin nimi on grok-4.7, ja se maksaa 2 dollaria miljoonaa syötetokenia kohden ja 6 dollaria miljoonaa vastetokenia kohden – täsmälleen saman verran kuin Grok 4.6 High. Konteksti-ikkuna on 500 000 tokenia ja tietojen ajankohtaisuus päättyy toukokuuhun 2026. Ne, jotka haluavat enemmän nopeutta, voivat valita nopean variantin, jossa on kaksinkertainen suoritusnopeus kaksinkertaiseen hintaan.

Hyödyt ovat todellisia – mutteivät kaikkialla

Yhtiö raportoi taulukon seitsemästä suorituskykytestistä (benchmark). Kolme niistä osoittaa selvää edistystä. EEBench-testissä Grok 4.7 saa tuloksen 64,0, kun 4.6 sai 53,0. Harvey Legal Agent -testissä, joka mittaa lakiagenttien työtä, yhtiö raportoi tuloksen 19,6, kun edeltäjä sai 15,8 ja kaksi vertailtua kilpailevaa mallia saivat 2,5 ja 6,7. Dramaattisin ero on Terminal-Bench 4.0 -testissä, jossa 4.7 yltää 38,0 pisteeseen vasten 4.6:n 20,3 pistettä – lähes tuplaus puolessa vuodessa.

Mainos:

Mutta taulukko näyttää myös, missä malli ei johda. Samassa Terminal-Bench 4.0 -testissä kilpailija Fable 5.1 saa tuloksen 57,9, mikä on selvästi Grok 4.7:n yläpuolella. CursorBench 4.0:ssa Grok 4.7 saa 46,3 pistettä Fablen 51,8:aa vastaan, ja HealthBench Professionalissa 56,7 vastaan 62,1. Yhtiön omassa Elo-mittauksessa GDPval-alustalla Grok 4.7 xHigh saa tuloksen 1 695 – sijoittuen Grok 4.6 High’n (1 605) ja GPT-6 Astra Maxin (1 542) yläpuolelle, mutta Fable 5.1 Maxin (1 735) alapuolelle.

Yhtiön oma myyntiargumentti ei siis ole kärkipaikka joka testissä, vaan hinta-laatusuhde: saman tason tuloksia 2 ja 6 dollarilla per miljoona tokenia, kun taulukon vertailumallit ovat hinnoiltaan 4/20 dollaria ja 10/50 dollaria. Mitään tuloksista ei ole riippumattomasti varmistettu, ja jokainen taulukon luku on SpaceXAI:n itsensä mittaama ja julkaisema.

Kaupunkiympäristön rakennuspeli demina

Konkreettisena esimerkkinä yhtiö näyttää molemmat malliversiot saman tehtävän parissa: avoimen maailman kaupunginrakennuspelin luomisessa. Grok 4.7 näytetään ensin, Grok 4.6 sen jälkeen. Tämä on juuri sellainen tehtävä, johon pidemmän koulutuksen sanotaan tähtäävän – useita tunteja kestävä työ, jossa mallin on pidettävä koodi, rakenne ja omat tarkistuksensa koossa pitkän matkan ajan ilman, että ihminen ohjaa jokaista askelta.

Yhtiö valitsi demon itse, eikä se kerro mitään siitä, miten malli käyttäytyy todellisessa koodikannassa todellisella asiakkaalla. Se kuitenkin havainnollistaa koko alan suuntaa: kilpailu on siirtynyt nopeista vastauksista agentteihin, jotka jatkavat työtään itsenäisesti tuntikausia. Tässä toimittajat nyt kirittävät toisiaan, ja tässä myös virheet tulevat kalliiksi, sillä pitkään ilman valvontaa työskentelevä malli voi ehtiä tehdä paljon ennen kuin kukaan huomaa sen olevan väärillä jäljillä.

Turvakerros ja luvut, jotka eivät ole sata

SpaceXAI kuvailee Grok 4.7:ää yhtiön tähän asti parhaiten kalibroidulla turvakerroksella – täysin uudella niin sanotulla suojapinolla (safeguard stack), jonka yhtiö sanoo olevan vahvin kieltäytymisessä ja ”jailbreak”-yritysten vastustamisessa. Julkisuuteen annettiin kaksi lukua. HackerBench v0.3 -testissä 3,3 prosenttia riskialttiista kaksoiskäyttökehotteista pääsee läpi. LatchBios-bioturvallisuusmittauksessa raportoidaan tulos 62,4 prosenttia.

Toisin sanoen: hieman useampi kuin kolme sadasta riskialttiista pyynnöstä menee edelleen läpi, ja bioturvallisuustulos on kaukana täydellisestä pistemäärästä. Yhtiö on myös kutsunut valittuja kyberturvallisuuskumppaneita suljettuihin ”red-team”-harjoituksiin puolustustutkimusta varten. Kumppaneita ei nimetty, ja julkaistut luvut ovat yhtiön omia mittauksia yhtiön omilla testisarjoilla.

Missä malli on saatavilla – ja mitä tapahtuu nyt

Saatavuus ratkaisee sen, kuinka nopeasti julkaisu saa käytännön merkitystä. Grok 4.7 on saatavilla ensimmäisestä päivästä lähtien Cursorissa ja Grok Buildissa sekä Grok-rajapinnassa, ja lisäksi kolmannen osapuolen koodausympäristöjen, mallireitittimien ja pilvipalveluiden kautta. Jokainen, joka jo ajaa grok-4.6-mallia tuotannossa, vaihtaa käytännössä mallin nimen koskematta budjettiin.

Tahti on huomioitavan arvoinen. Heinäkuussa julkaistiin Grok 4.5 samaan hintaan, 2 ja 6 dollaria miljoonaa tokenia kohden, ja samalla 500 000 tokenin konteksti-ikkunalla. Sen jälkeen yhtiö on vaihtanut nimeään, ohittanut version 4.6 ja nyt 4.7 – muuttamatta hintaa kertaakaan. Hinnastosta on tullut alan kiintopiste, kun taas sen alla olevat mallit vaihtuvat kuukausittain.

Se, mitä asiakas tosiasiallisesti saa muuttumattomalla 2 ja 6 dollarilla, ei siis ratkea taulukoiden perusteella, vaan sen mukaan, miten uusi malli käyttäytyy tuntikausia kestävissä agenttiajoissa yrityksissä, jotka antavat sen työskennellä omien järjestelmiensä sisällä. Tuo testi alkaa nyt, ja sen tekevät muut kuin yhtiö itse.